Sur cette page
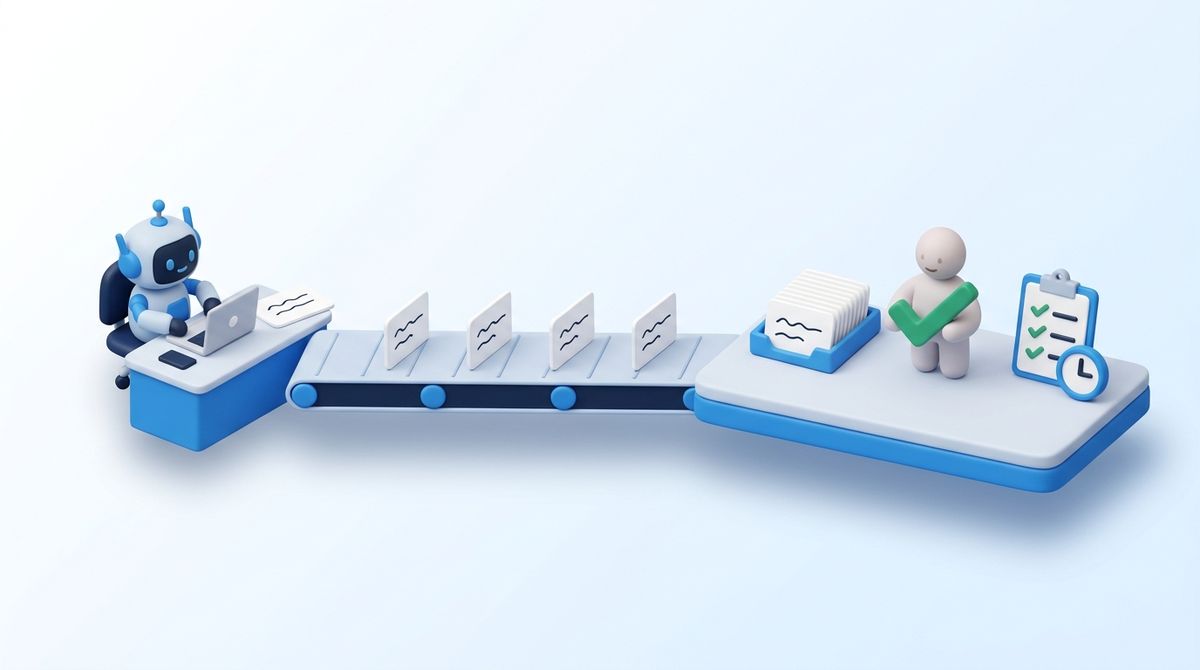
Une routine de traduction est une tâche d'agent de code qui s'exécute selon un planning ou en CI : elle trouve les chaînes qui ont changé, les rédige dans chaque langue cible, écrit les fichiers de langue et ouvre une pull request. Avec Claude Code, Codex ou un autre agent de code, il suffit d'un fichier de skill et d'une ligne cron, et certaines équipes en construisent une pour remplacer leur système de gestion de traduction.
La question est donc légitime : avez-vous encore besoin d'un TMS ? Pour certaines équipes, non. Pour la plupart, la réponse n'est pas « le TMS à la place de la routine » mais « la routine par-dessus un TMS ». Ce billet explique quand la routine suffit, ce qu'elle doit reconstruire quand ce n'est plus le cas, et trois façons de la garder.
- Une routine rédige bien : elle voit le code, les placeholders et le texte voisin, et n'a besoin d'aucun passage de relais.
- Elle suffit tant que l'équipe lit chaque langue et que personne en dehors du dépôt n'a à toucher au texte.
- Au-delà, elle doit reconstruire une mémoire d'une exécution à l'autre, un glossaire appliqué, une relecture par langue avec une trace, des contrôles sur l'ensemble de la langue, une livraison sans redéploiement, et des preuves pour quiconque demande qui a approuvé un texte.
- Vous n'avez pas à choisir : avec une clé API de projet, la routine ajoute une étape de synchronisation et ses ébauches arrivent marquées à relire ; via le serveur MCP, elle lit d'abord le glossaire et la mémoire, et ses écritures sont consignées comme celles de l'agent.
- C'est vous qui validez les traductions ? Ce qu'obtient la personne qui approuve le texte, et la seule étape à faire de votre côté.
À quoi ressemble la routine
Une routine a généralement trois parties :
- Un fichier de skill ou d'instructions avec les règles : garder les placeholders, ajouter chaque forme de pluriel dont la langue a besoin, respecter le ton, ne jamais toucher à la langue source.
- Un déclencheur : un planning cron, une fusion dans la branche principale, ou un label sur une pull request.
- L'exécution : l'agent compare le fichier de la langue source aux fichiers cibles, rédige les valeurs manquantes, les écrit et ouvre une pull request.
Ses atouts sont réels. L'agent qui rédige le libellé allemand d'un bouton sait que c'est un bouton, que {{count}} est un nombre et non un nom, ce que disent les chaînes voisines et combien de place laisse la mise en page. Pas d'export, pas de passage de relais, pas d'attente d'un cycle de traduction, et des fonctionnalités qui sortaient autrefois en anglais uniquement sortent désormais dans toutes les langues du projet.
Quand la routine seule suffit
Gardez-la telle quelle, sans TMS, tant que tout ceci reste vrai :
- l'équipe lit chaque langue cible, ou elles sont assez peu nombreuses pour être vérifiées à la main ;
- rien ne dépend du texte : pas de parcours de paiement, pas de texte juridique, pas de contenu réglementé ;
- une seule équipe est responsable du produit, et personne en dehors du dépôt n'a à modifier une chaîne.
Cela décrit beaucoup de projets. Si cela décrit le vôtre, la suite de ce billet est la liste des points à surveiller.
Ce qu'elle doit reconstruire ensuite
Chaque exécution d'une routine est sans état : elle sait ce qu'il y a dans le dépôt aujourd'hui et ce que dit son prompt. Les lacunes ne se voient pas dans une pull request ; elles se voient d'une version à l'autre. La raison pour laquelle chacune dérive est expliquée dans quand les agents de code traduisent votre application ; ici, c'est la liste de ce qu'il faut construire.
| Ce dont le travail a besoin | Ce que fait la routine | Ce que votre équipe doit ensuite faire tourner, à chaque version |
|---|---|---|
| Une mémoire d'une exécution à l'autre | Voit les fichiers actuels, mais rien ne lui dit quelles traductions ont été approuvées, et la rédaction par IA varie d'une exécution à l'autre, la nôtre comprise : dans notre propre essai, les mêmes clés avec le même contexte sont revenues en allemand une fois en « Zurückstellen » et une fois en « Schlummern », jusqu'à ce qu'une entrée de glossaire tranche | Un stock de traductions approuvées que chaque exécution consulte, tenu à jour chaque fois que quelqu'un en corrige une |
| Terminologie | Un glossaire collé dans le prompt, qui grossit, jamais appliqué | Un glossaire par langue, un contrôle sur chaque sortie, et quelqu'un qui est responsable des termes |
| Relecture par langue | Un relecteur de pull request lit une ou deux des langues | Un relecteur par langue, une file qu'il traite, et une trace de chaque décision |
| Contrôles sur l'ensemble de la langue | Regarde le diff | Des contrôles des placeholders, des formes de pluriel, des balises et de la cohérence qui s'exécutent après chaque fusion, et quelqu'un qui corrige ce qu'ils signalent |
| Correctifs sans nouvelle version | Une chaîne corrigée attend le prochain déploiement | Une livraison à l'exécution, avec un cache qui ne sert jamais une chaîne périmée (comment cela fonctionne) |
| Preuves | git blame montre un bot | Une origine et un statut de relecture par chaîne, et un export qu'un auditeur accepte |
| Les personnes en dehors du dépôt | Un product manager ou un traducteur a besoin d'un accès au dépôt | Un éditeur avec des comptes, des rôles et un contrôle d'accès |
Aucun de ces éléments n'est difficile en soi. Ensemble, ils forment un système de gestion de traduction, écrit et maintenu par l'équipe qui voulait justement cesser d'en faire tourner un.
Trois façons de garder la routine
L'alternative à la reconstruction est de garder la routine et de la laisser écrire dans un système qui possède déjà ces éléments. Dans Locize, il existe trois configurations, du changement le plus léger à celui qui apporte le plus de contexte, et toutes trois s'exécutent sans surveillance en CI.
| 1. Ajouter une étape de synchronisation | 2. Laisser Locize rédiger | 3. Lire d'abord le projet | |
|---|---|---|---|
| Qui rédige | votre routine, comme aujourd'hui | la traduction automatique de Locize | votre routine |
| Identifiant | clé API de projet | clé API de projet | jeton d'accès personnel |
| Changement dans la routine | une commande sync après elle | son étape de rédaction disparaît | des outils MCP au lieu de fichiers |
| Glossaire, guide de style, mémoire | non utilisés pendant la rédaction | utilisés pendant la rédaction | lus avant la rédaction |
| Consigné comme sortie machine ou d'agent | non, seulement marqué à relire | oui | oui, avec le nom de l'agent |
Laquelle convient :
| Votre situation | Convient |
|---|---|
| Deux ou trois langues que l'équipe lit, rien ne dépend du texte | la routine seule |
| La routine fonctionne, mais personne dans l'équipe ne lit certaines des langues | 1 |
| Une phrase de contexte par clé suffit, et le glossaire et la mémoire doivent servir pendant la rédaction | 2 |
| Les chaînes ont besoin du code pour être bien traduites, ou la trace doit montrer ce qu'un agent a écrit | 3 |
| Le service juridique, un client ou un auditeur demande qui a approuvé le texte | 2 ou 3, avec la relecture activée |
La routine continue de payer ses propres tokens de modèle ; les traductions que Locize rédige consomment des tokens IA Locize ou votre propre clé de fournisseur (tarifs).
Les trois aboutissent au même endroit : une file de relecture par langue, où chaque ébauche attend qu'une personne qui lit la langue la confirme.
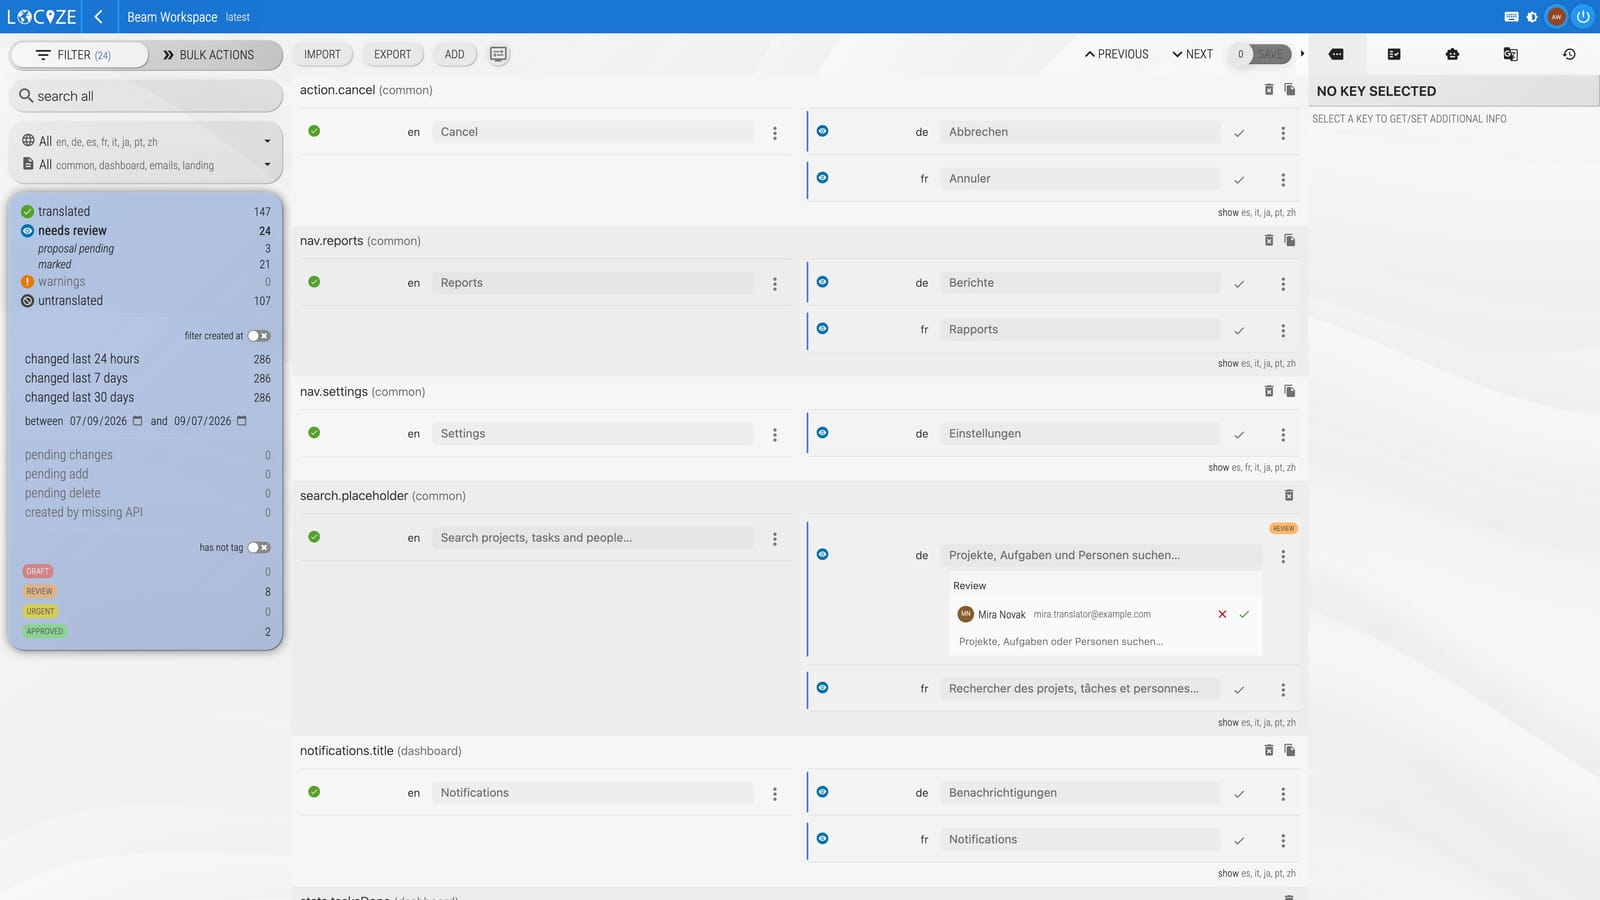
Ce que cela permet de repérer, d'après un vrai essai avec la configuration 2 : un agent a signalé 11 clés anglaises, et la traduction automatique de Locize est revenue avec 69 valeurs en six langues en environ onze secondes, chacune avec un score de confiance et une justification, et avec les formes de pluriel dont chaque langue a besoin (trois en français, une en japonais) là où l'anglais en a deux. Les scores ont désigné les traductions littérales de « Wake up » en allemand, en espagnol et en japonais. Et l'allemand utilisait deux termes pour la même action, ce qu'un score par chaîne ne peut pas voir et qu'un relecteur de cette langue voit. Les ébauches que votre routine envoie elle-même, dans les configurations 1 et 3, arrivent sans score ; un passage d'AI review les note.
1. Ajouter une étape de synchronisation
Gardez la routine telle quelle. Une fois qu'elle a écrit les fichiers, envoyez les nouvelles valeurs cibles à Locize, marquées à relire :
locize sync --api-key $LOCIZE_API_KEY --project-id $LOCIZE_PROJECTID \
  --reference-language-only false --needs-review true \
  --skip-delete true --auto-translate false
--reference-language-only falsecompare aussi les langues cibles, si bien que les ébauches de la routine sont envoyées.--needs-review truemarque chaque valeur que la synchronisation envoie : elle est mise en ligne et reste dans la file des relecteurs jusqu'à ce que quelqu'un la confirme (locize-cli 12.8.0 ou plus récent). Avec--review trueà la place, les valeurs arrivent sous forme de propositions de relecture et ne sont mises en ligne qu'une fois acceptées.--auto-translate falseempêche Locize de traduire lui-même les nouvelles clés sources, pour qu'il n'entre pas en concurrence avec les ébauches de la routine.--skip-delete trueévite qu'une valeur que quelqu'un a ajoutée dans Locize, et que les fichiers n'ont pas encore, soit supprimée (les clés retirées de la source restent alors dans Locize jusqu'à ce que vous les y supprimiez).
La correction d'un relecteur n'est pas annulée par l'exécution suivante : Locize garde la valeur qu'il a pour une clé existante, et la synchronisation la réécrit dans les fichiers. Un point à régler avant la première exécution : si votre équipe modifie des textes anglais dans le dépôt, lancez locize sync --update-values true avant la routine, sinon la synchronisation réécrit l'anglais de Locize par-dessus. La synchronisation compare avec les fichiers publiés, utilisez donc une version avec publication automatique ; le reste se trouve dans la référence de sync de locize-cli.
Essayez-le à la prochaine exécution de la routine : démarrez un essai gratuit de 14 jours, créez un projet avec vos langues, stockez sa clé API comme secret CI, ajoutez la commande après la routine, et ouvrez le filtre « needs review » dans l'éditeur une fois qu'elle a tourné. La première synchronisation envoie toutes les valeurs cibles que la routine a écrites jusqu'ici, si bien que la file montre ce que les exécutions précédentes ont livré sans second regard. Déjà sur Locize ? Utilisez la clé API de votre projet et ajoutez l'étape ; rien d'autre ne change.
La limite : les valeurs arrivent marquées à relire, mais dans l'historique et l'export de provenance, elles ressemblent à n'importe quelle autre valeur envoyée avec la clé API. Cela suffit pour la relecture, mais pas quand la trace doit distinguer le texte d'un agent de celui d'une personne ; c'est ce que fait la configuration 3.
2. Laisser Locize rédiger
La routine continue d'écrire la fonctionnalité et le texte source, et l'étape de traduction passe à Locize. L'action GitHub de Locize extrait les nouvelles clés, les synchronise, les fait traduire et télécharge le résultat, avec la même clé API de projet :
- uses: locize/translate@v2
  with:
    project-id: ${{ secrets.LOCIZE_PROJECTID }}
api-key: ${{ secrets.LOCIZE_API_KEY }}- La traduction automatique utilise le guide de style, le glossaire et la mémoire de traduction du projet comme contexte, et vérifie chaque résultat par rapport à sa source (syntaxe, placeholders, balises, formes de pluriel dont la langue a besoin) avant de l'enregistrer ; les résultats IA sont en plus tenus de respecter le glossaire.
- Avec Quality Estimation, chaque traduction IA reçoit un score de confiance, et les réglages de relecture décident si toutes les traductions automatiques sont marquées à relire ou seulement celles auxquelles le score ne fait pas confiance.
- Sur une pull request,
command: syncne traduit que les clés que la pull request a modifiées.
L'action attend un fichier i18next.config (lancez npx i18next-cli init une fois). En dehors d'i18next, locize sync --auto-translate true fait la même chose avec la CLI. Cette configuration convient quand une phrase de contexte par clé suffit, et elle laisse à l'agent la partie où il excelle.
3. Laisser la routine lire d'abord le projet
Quand une chaîne a besoin de ce que seul le code montre, laissez l'agent rédiger, mais via le serveur MCP de Locize plutôt que dans des fichiers. L'exécution lit avant d'écrire :
find_missing_translationspar langue : ce qui manque ou est périmé.get_glossary,get_styleguideetsearch_translation_memory: les termes, la voix et les décisions antérieures ;get_screenshot_contextpour une clé ambiguë.- L'agent rédige, avec le code sous les yeux.
update_translationsavecquality: "AI": les ébauches sont déclarées comme sortie IA et marquées à relire selon la règle du projet.
Selon un planning dans GitHub Actions, avec Claude Code :
name: nightly translations
on:
  schedule:
    - cron: '0 3 * * 1-5'
  workflow_dispatch:

permissions:
  contents: read

jobs:
  translate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - run: npm install -g @anthropic-ai/claude-code@2.1.317
      - run: |
          claude mcp add --transport http locize https://mcp.locize.app --header "Authorization: Bearer $LOCIZE_PAT"
        env:
          LOCIZE_PAT: ${{ secrets.LOCIZE_PAT }}
      - run: >
          claude -p "Translate the missing keys of the Locize project $LOCIZE_PROJECTID, version latest.
          Call get_project_stats for version latest to see its languages and namespaces (if it answers with totals only, call it again per language),
          then call find_missing_translations per language and namespace.
          Before drafting call get_glossary, get_styleguide and search_translation_memory, and reuse a translation memory match with a high score.
          Read the namespace's existing translations with get_translations to match their tone. Look up where each key is used in the code to see what it labels.
          Push the drafts with update_translations and quality AI. Never send a null value, never publish, delete or rename anything.
          End with a list of what you pushed and what you were unsure about."
          --disallowedTools "Bash,Edit,Write,WebFetch,WebSearch,Read(~/.claude.json),Read(~/.claude/**)"
          --allowedTools "mcp__locize__get_project_stats,mcp__locize__find_missing_translations,mcp__locize__get_translations,mcp__locize__get_glossary,mcp__locize__get_styleguide,mcp__locize__search_translation_memory,mcp__locize__get_screenshot_context,mcp__locize__update_translations,Read,Grep,Glob"
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
LOCIZE_PROJECTID: ${{ vars.LOCIZE_PROJECTID }}- Le jeton : créez un jeton d'accès personnel avec uniquement les scopes
readetwrite, définissez une date d'expiration, et stockez-le comme secret du dépôt. Un jeton atteint tous les projets que son propriétaire peut atteindre : rattachez-le donc à un utilisateur qui n'est membre que de ce projet. Nommez-le d'après la routine, par exemple « Routine de traduction nocturne » : chaque écriture via MCP porte la marque de l'agent avec le nom du jeton, si bien que l'historique nomme l'agent, et l'export de provenance liste les ébauches comme sortie machine avec le nom de l'agent, et non comme la modification d'une personne. - Ce qu'il peut faire : la liste d'outils exclut les outils structurels (suppression ou renommage de namespaces, publication, branches).
update_translationspeut tout de même supprimer une clé quand on lui envoie une valeur null, et seul le prompt dit de ne pas le faire ; si le propriétaire du jeton a la permission translate-only, le serveur refuse lui-même les suppressions de clés et les changements structurels. - Ce qu'il lit : l'agent lit du texte écrit par d'autres (traductions, glossaire, contextes de clés). Le workflow lui interdit explicitement le shell, les modifications de fichiers et le web, car
--allowedToolsne fait qu'ajouter à ce que les réglages Claude autorisent déjà, y compris un.claude/settings.jsondans le dépôt récupéré. Il lui interdit aussi de lire sa propre configuration (oùclaude mcp addstocke le jeton), et ses ébauches passent en relecture. - Autour : les clés sources arrivent toujours dans Locize comme avant (saveMissing,
locize syncoureport_missing_keys), et l'application récupère les traductions relues depuis le CDN ou avec unlocize downloadau build. Si la traduction automatique est activée pour le projet, Locize rédige d'abord les nouvelles clés et la routine trouve peu de choses manquantes ; désactivez-la quand c'est la routine qui doit rédiger. - Autres agents : un agent de code qui parle MCP sur HTTP prend la même URL et le même en-tête dans ses réglages MCP. Les fichiers de conventions de locize-agents portent aussi les règles « lire avant de rédiger » pour les sessions interactives.
À quoi ressemble une exécution : sur un projet de test avec trois nouvelles clés et l'allemand, le français et le russe comme langues cibles, la routine a lu les statistiques, les clés manquantes, le glossaire, le guide de style et la mémoire de traduction, a cherché chaque clé dans le code, et a poussé neuf ébauches comme sortie IA, pour moins d'un dollar de tokens de modèle. Elle a terminé par ce dont elle n'était pas sûre : elle avait rendu « Wake up » par « réactiver » ou « reprendre », pas littéralement, ce qui fait disparaître la métaphore du snooze. Les neuf ébauches étaient toutes dans la file « needs review », et l'historique nommait le jeton comme agent à côté de chacune.
Pour une exécution interactive complète avec la sortie réelle (les scores de confiance, ce qu'ils ont manqué, la relecture et l'export), voir un agent de code localise une fonctionnalité, étape par étape.
Si c'est vous qui validez
La routine est un outil de développeur ; la question « qui a approuvé ce texte ? » arrive généralement chez quelqu'un d'autre : le responsable de la localisation, le product owner, ou la personne qui répond au service juridique ou aux achats d'un client. Dans les trois configurations, voici ce que cette personne obtient :
- Des relecteurs par langue. Un relecteur peut être limité à ses langues, et la permission translate-only modifie des valeurs sans supprimer de clés ni changer la structure du projet (rôles et permissions).
- Une seule file, quel que soit l'auteur de l'ébauche. Les valeurs de la routine, de la traduction automatique et des personnes arrivent dans la même file « needs review » par langue (workflow de relecture) ; sur un plan avec notifications, une notification peut partir quand la file d'une langue dépasse un seuil.
- Une trace par chaîne. L'historique conserve qui ou quoi a écrit chaque valeur, qui l'a confirmée, et quand.
- Des preuves sur demande. L'export de provenance (CSV et JSON par version, langue ou namespace, à partir du plan Growth, comme les propositions de relecture) rassemble le statut de relecture pour un auditeur. Le guide du workflow article 50 montre la configuration, et notre explication précise quand l'article 50 s'applique.
- Un second regard, à la demande. Un passage d'AI review sur une version note les traductions qu'un projet possède déjà, quel qu'en soit l'auteur, et marque à relire celles dont il doute ou les transforme en propositions de relecture avec une justification et une correction suggérée. Un agent peut en lancer un avec
start_ai_reviewet un plafond de budget, avec un jeton qui a le scopemanageet un rôle admin ou manager.
Votre étape : configurez la relecture par langue comme le décrit le guide du workflow article 50, laissez la routine tourner une fois, puis téléchargez l'export de provenance de cette version et comparez-le à ce que demande votre auditeur ou votre client. L'essai de 14 jours d'un projet inclut la relecture et l'export ; ensuite, les deux sont disponibles à partir du plan Growth.
Les signaux que la routine a besoin d'un système sous elle
- la première langue que personne dans l'équipe ne lit ;
- la première plainte terminologique d'un client, des ventes ou du support ;
- le premier « qui a changé cette chaîne, et pourquoi ? » ;
- le premier correctif qui doit atteindre les utilisateurs avant la prochaine version ;
- la première question du service juridique ou des achats d'un client sur les textes générés par IA.
L'agent continue de rédiger ; cette partie n'a jamais été le problème. Ce dont il a besoin en dessous, c'est d'une mémoire, d'un relecteur et d'une trace. Si votre routine tourne déjà, démarrez un essai gratuit de 14 jours, donnez à la routine une clé API de projet, ajoutez la commande sync, et regardez la file de relecture après la première exécution. Déjà sur Locize ? La clé API de votre projet est tout ce dont la routine a besoin.
Questions fréquentes
Ai-je encore besoin d'un système de gestion de traduction si un agent de code traduit mon application ?
Pas toujours. Une routine qui laisse Claude Code, Codex ou un autre agent de code rédiger les chaînes manquantes et ouvrir une pull request suffit tant que l'équipe lit chaque langue cible, que rien ne dépend du texte et que personne en dehors du dépôt n'a à modifier une chaîne. Au-delà, la routine doit reconstruire une mémoire de traduction, un glossaire appliqué, une relecture par langue avec une trace, des contrôles sur l'ensemble de la langue et une livraison sans redéploiement. La voie la moins coûteuse n'est généralement pas de remplacer la routine, mais de la laisser écrire dans un système de gestion de traduction qui possède déjà ces éléments, pendant que l'agent continue de rédiger.
Une routine Claude Code ou Codex planifiée peut-elle écrire dans Locize ?
Oui, sans surveillance. Avec la CLI Locize ou l'action GitHub de Locize, elle utilise une clé API de projet : sur une version avec publication automatique, locize sync avec --reference-language-only false et --needs-review true envoie les valeurs cibles rédigées marquées à relire et n'écrase pas les valeurs qui existent déjà dans Locize. Via le serveur MCP de Locize à https://mcp.locize.app, elle utilise un jeton d'accès personnel comme en-tête Bearer, lit le glossaire, le guide de style et la mémoire de traduction avant de rédiger, et pousse ses ébauches déclarées comme sortie IA avec update_translations.
Comment garder une trace des traductions écrites par un agent ?
Écrivez via le serveur MCP de Locize et poussez les ébauches avec quality "AI" : elles sont marquées à relire selon la règle du projet, et chaque écriture via MCP porte la marque de l'agent avec le nom du jeton, si bien que l'historique et l'export de provenance ne présentent pas les ébauches comme celles d'une personne. Un relecteur limité à sa langue confirme ou modifie chaque valeur, et la décision est consignée. La CLI peut marquer les valeurs poussées à relire, mais elle ne déclare pas qui les a écrites.
Qui doit traduire : l'agent de code ou le TMS ?
Les deux fonctionnent, et les deux ébauches arrivent dans la même file de relecture. Laissez l'agent rédiger quand une chaîne a besoin de ce que seul le code montre : sur quel élément se trouve un libellé, combien de place il a, ce que contient un placeholder. Laissez le TMS rédiger quand une phrase de contexte par clé suffit ; la traduction automatique de Locize utilise le guide de style, le glossaire et la mémoire de traduction comme contexte et vérifie chaque résultat par rapport à sa source avant de l'enregistrer.
Le règlement européen sur l'IA change-t-il quelque chose pour les chaînes traduites par un agent ?
L'article 50 du règlement européen sur l'IA s'applique depuis le 2 août 2026. Selon les lignes directrices finales de la Commission européenne du 20 juillet 2026, une traduction IA fidèle est exemptée de l'obligation de marquage lisible par machine de l'article 50(2) ; l'obligation de divulgation visible de l'article 50(4) ne couvre que les textes publiés pour informer le public sur des questions d'intérêt public, et elle tombe lorsque le texte a fait l'objet d'une relecture humaine substantielle ou d'un contrôle éditorial sous la responsabilité éditoriale d'une personne. Une approbation de pull request montre que quelqu'un a approuvé un diff, pas qui a relu chaque langue ; une relecture par langue et par chaîne, consignée avec le nom du relecteur, le montre. Ceci n'est pas un conseil juridique.
Fatigué de gérer vos traductions à la main ?
Locize est le backend de gestion de traductions créé par l'équipe i18next : diffusion CDN, traduction IA, édition in-context, sans redéploiement.
Démarrez votre essai gratuit de 14 joursArticles similaires