
Un agent de code localise une fonctionnalité : scores de confiance, relecture et trace, étape par étape
La localisation par agent de code signifie que l'assistant IA qui écrit votre fonctionnalité branche aussi ses chaînes : il ajoute les appels t(), signale les nouvelles clés et récupère les traductions. La partie intéressante, c'est ce qui se passe ensuite. Nous l'avons fait tourner une fois, pour de vrai, sur notre application de démonstration Taskly : Claude Code a ajouté une fonction de mise en attente (snooze), a signalé onze clés à Locize via MCP et les a récupérées en six langues environ onze secondes plus tard, chaque traduction avec un score de confiance et une justification. Ce billet montre chaque étape avec la sortie réelle : ce que les scores ont détecté, ce qu'ils ont manqué, ce que l'agent a corrigé de lui-même, ce que la relecture a encore changé, et ce que dit la trace à la fin.
Le pourquoi de ce schéma (et quand s'en passer) se trouve dans quand les agents de code traduisent votre application. Ici, c'est le comment.
- 11 clés signalées par l'agent, 69 traductions IA de retour en 6 langues (allemand, espagnol, français, italien, japonais, portugais), environ 11 secondes entre le signalement et la publication, notation comprise.
- 0 sur 69 sous le seuil de relecture par défaut de 0,7. Le score le plus bas (0,7) et les deux scores de 0,8 sont tous allés à la même chaîne : « Wake up ».
- Ce que les scores ont manqué : un terme allemand utilisé de façon incohérente d'une clé à l'autre, un bug dans la façon dont le code de l'agent construisait une phrase, et une chaîne allemande notée 1,0 que la relecture a tout de même réécrite. L'agent a repéré le premier ; la relecture a repéré les deux autres.
- La trace : chaque valeur reçoit au final un statut de relecture dans l'export de provenance (ici : 9 relues par un humain, 1 modifiée par un humain, 11 écrites par l'agent, 59 sorties machine que personne n'a encore vérifiées), si bien que « une personne a vérifié ceci » est quelque chose que vous pouvez montrer chaîne par chaîne, tout comme son absence.
La configuration
- L'application : Taskly, une petite application de tâches en Vite, React et TypeScript, internationalisée avec i18next et react-i18next. Source en anglais, six langues cibles dans le projet Locize (le dépôt en livre cinq ; le portugais a été ajouté dans Locize), un namespace d'une centaine de clés, un guide de style informel et un glossaire qui, pour l'instant, ne protège que le nom du produit.
- L'agent : Claude Code dans l'application de bureau Claude, avec le serveur MCP de Locize ajouté comme connecteur (
https://mcp.locize.app, connexion OAuth). Dans la CLI Claude Code, le même serveur s'ajoute avecclaude mcp add --transport http locize https://mcp.locize.app, puis/mcppour se connecter. Cursor et les autres clients MCP fonctionnent de la même façon. - Les réglages du projet : traduction automatique activée, Quality Estimation activée, plus le Review AI workflow qui envoie les traductions IA à faible confiance en propositions de relecture.
- Une branche : l'agent a créé une branche du projet pour la fonctionnalité (
create_branch), de sorte que les nouvelles chaînes restent hors du projet principal jusqu'à leur relecture et leur fusion. Une branche reprend du projet la traduction automatique, Quality Estimation et le Review AI workflow au moment de sa création.
Étape 1 : le contexte avant l'ébauche
Avant d'écrire la moindre chaîne, l'agent a demandé au projet ses règles : get_styleguide a renvoyé ton : informel, public : usage personnel, et get_glossary a renvoyé un seul terme, le nom du produit, à garder tel quel, « Taskly », dans chaque langue. Rien sur « snooze ». Cette lacune compte plus loin.
Étape 2 : écrire le code, signaler les clés
La fonctionnalité : mettre une tâche en attente jusqu'à plus tard dans la journée, demain matin ou la semaine prochaine, afficher quand elle revient, compter les tâches en attente dans la barre latérale, et faire revenir une tâche plus tôt. L'agent a écrit le composant avec des appels t() et des clés imbriquées sous snooze :
const OPTIONS = ['laterToday', 'tomorrowMorning', 'nextWeek'] as const

<button onClick={() => setOpen(true)}>{t('snooze.action')}</button>
<h3>{t('snooze.menuTitle')}</h3>
{OPTIONS.map((o) => (
  <button key={o} onClick={() => snooze(task, o)}>{t(`snooze.${o}`)}</button>
))}
<span>{t('snooze.snoozedUntil', { date: formatShortDate(task.snoozedUntil) })}</span>
<span>{t('snooze.count', { count: snoozedCount })}</span>
<button onClick={() => wake(task)}>{t('snooze.wakeUp')}</button>
{snoozed.length === 0 && <p>{t('snooze.empty')}</p>}

// after snoozing
toast(t('snooze.toast', { title: task.title, when: t(`snooze.${o}`).toLowerCase() }))
Puis il a signalé les onze clés anglaises avec report_missing_keys, chacune avec une phrase de contexte pour le traducteur (humain ou IA) :
{
  "snooze.wakeUp": {
    "value": "Wake up",
    "context": { "text": "Button on a snoozed task. Brings the task back to the active list right now." }
  },
  "snooze.toast": {
    "value": "Snoozed “{{title}}”. We’ll nudge you {{when}}.",
    "context": { "text": "Toast after snoozing a task. {{title}} is the task title. {{when}} is one of the snooze option labels in lower case, for example: tomorrow morning." }
  }
}
report_missing_keys ne fait qu'ajouter des clés, il n'écrase jamais rien. Signaler dans la langue de référence suffit : la traduction automatique prend le relais.
Étape 3 : ce qui est revenu
Environ onze secondes plus tard, les six langues étaient traduites, notées et (parce que la version de développement publie automatiquement) sur le CDN. 69 valeurs à partir de 11 clés anglaises, car les formes de pluriel suivent chaque langue, pas la source anglaise :
| Langue | Valeurs | Formes de pluriel de snooze.count |
|---|---|---|
| Allemand | 11 | one, other |
| Espagnol, français, italien, portugais | 12 chacune | one, many, other |
| Japonais | 10 | other seulement |
L'agent a écrit deux formes anglaises. Le français, l'italien, l'espagnol et le portugais ont une troisième catégorie CLDR, many (utilisée pour les très grands nombres, comme un million), et le japonais n'en a qu'une. Locize a créé les formes dont chaque langue a besoin ; un agent qui écrit les fichiers de langue à la main doit le savoir.
Étape 4 : les scores de confiance
Chaque traduction IA a reçu une confiance entre 0 et 1 et une justification d'une phrase. Depuis le 13 octobre 2026, l'agent peut lire les deux avec get_translations et raw: true (qeScore, qeScoreReason), il n'a donc pas besoin d'attendre qu'une personne ouvre l'éditeur.
| Score | Valeurs |
|---|---|
| 1,0 | 53 |
| 0,95 | 4 |
| 0,9 | 9 |
| 0,8 | 2 |
| 0,7 | 1 |
| sous 0,7 | 0 |
Rien n'a été envoyé en propositions de relecture : l'envoi se fait sous le seuil (0,7 par défaut) ou quand l'évaluateur signale un problème majeur, et ni l'un ni l'autre ne s'est produit. Les justifications désignaient pourtant les chaînes les plus faibles :
| Clé | Langue | Traduction | Score | Justification (évaluateur) |
|---|---|---|---|---|
snooze.wakeUp | Espagnol | Despertar | 0,7 | Traduction littérale de « Wake up » ; « Reactivar » est plus idiomatique en gestion de tâches |
snooze.wakeUp | Allemand | Aufwecken | 0,8 | Traduction littérale ; « Aktivieren » ou « Wiederherstellen » convient mieux à une interface de tâches |
snooze.wakeUp | Japonais | 起こす | 0,8 | Un peu artificiel ; 今すぐ戻す convient mieux dans une application de tâches |
snooze.action | Allemand | Schlummern | 0,9 | Techniquement correct, mais « Zurückstellen » est plus idiomatique en gestion de tâches |
Le français, l'italien et le portugais ont bien rendu « Wake up » sans aide (Réactiver et Riattiva à 1,0, Retomar à 0,9). La phrase de contexte a fait son travail là ; dans les trois autres langues, le bouton parlait encore de réveiller quelqu'un.
Étape 5 : l'agent révise, et repère ce que les scores ont manqué
En lisant les scores, l'agent a trouvé quelque chose qu'aucun score isolé ne montre : l'allemand utilisait deux termes pour la même action. Cinq clés disaient « Schlummern », le toast disait « pausiert », et l'évaluateur avait noté ce toast 0,9, « haute qualité ». Quality Estimation note une chaîne à la fois, donc la cohérence entre les clés n'est pas quelque chose qu'elle peut voir.
La traduction IA variait aussi d'une exécution à l'autre. Nous avions déjà signalé une fois les mêmes clés avec le même contexte (les clés ont été supprimées puis signalées à nouveau sous les noms imbriqués) : cette première exécution avait choisi « Zurückstellen », la seconde « Schlummern ». Aucun des deux n'est faux ; livrer les deux, si. Sans entrée de glossaire, la rédaction varie d'une exécution à l'autre, le mode de défaillance que décrit l'article de catégorie, et la raison pour laquelle l'entrée de glossaire ci-dessous est le vrai correctif.
L'agent a poussé ses révisions avec update_translations et quality: "AI" : en allemand, « Zurückstellen » partout (toast compris), et « Wake up » rendu par Reaktivieren, Reactivar et 今すぐ戻す. Déclarées comme sortie IA, les révisions restent dans la file de relecture au lieu de compter comme approuvées. Puis il a lancé un passage d'AI review (start_ai_review) pour les noter à nouveau, car toute modification fait tomber l'ancien score :
- 10 valeurs vérifiées, 10 notées, 0 mise en doute, 1 746 tokens IA.
- L'allemand obtient désormais 1,0 partout sauf Reaktivieren (0,9) ; l'espagnol Reactivar 1,0, le japonais 今すぐ戻す 0,9.
- Une note honnête : lors du second passage, l'évaluateur a remarqué que « Aufwecken » aurait été « plus ludique/direct ». Au premier passage, il avait qualifié le même mot de traduction littérale. Un évaluateur aiguille, il ne juge pas.
Le correctif de la cause profonde est une entrée de glossaire pour « snooze » dans chaque langue. Le serveur MCP ne fait que lire le glossaire, donc ajouter le terme est une étape humaine, et c'est la bonne : la terminologie est une décision, pas une ébauche.
Étape 6 : la relecture
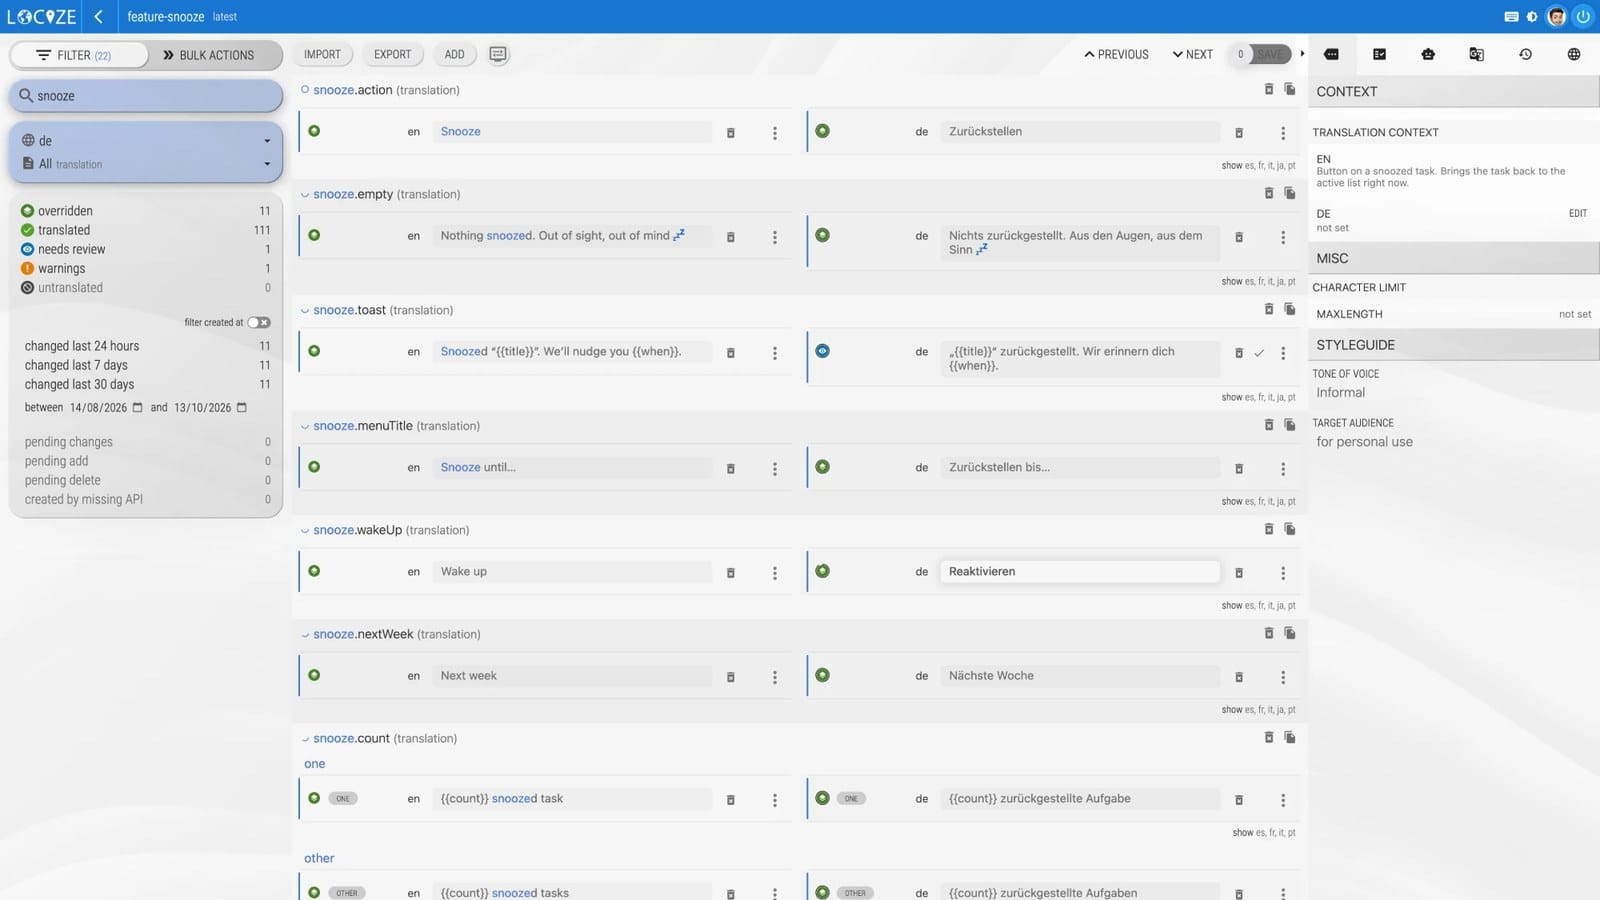
Les valeurs allemandes sont passées par la file de relecture de l'éditeur : chacune à côté de sa source, de la phrase de contexte de l'agent et du guide de style. Neuf ont été confirmées telles quelles. Deux choses avaient échappé à la fois à l'évaluateur et à l'agent :
- Une chaîne notée 1,0, « Traduction parfaite » : « Later today » était devenu « Heute später ». De l'allemand correct, mais comme option de menu, « Später heute » se lit plus naturellement, donc la relecture l'a modifié. La modification a supprimé le score, car un score ne décrit que le texte pour lequel il a été calculé.
- Un bug dans le propre code de l'agent. Le toast insère un libellé d'option traduit, mis en minuscules, dans une phrase : sans problème pour « tomorrow morning », faux en allemand, où les noms prennent une majuscule : « Wir erinnern dich nächste woche. » Aucun score ne peut voir cela, car chaque chaîne est correcte isolément. Le correctif a sa place dans le code : un toast par option, avec le contexte i18next au lieu de la concaténation de chaînes.
// before: toast(t('snooze.toast', { title, when: t(`snooze.${o}`).toLowerCase() }))
toast(t('snooze.toast', { context: o, title: task.title }))
// keys: snooze.toast_laterToday, snooze.toast_tomorrowMorning, snooze.toast_nextWeek
Le toast allemand est resté non confirmé : son texte est correct, mais la clé va être remplacée par les clés de contexte ci-dessus.
C'est la répartition du travail que suggère cet essai : l'évaluateur classe les chaînes une à une, l'agent vérifie la cohérence sur l'ensemble du lot et corrige ce qu'on lui indique, et la relecture repère ce qui est juste isolément et faux en situation.
Étape 7 : la trace
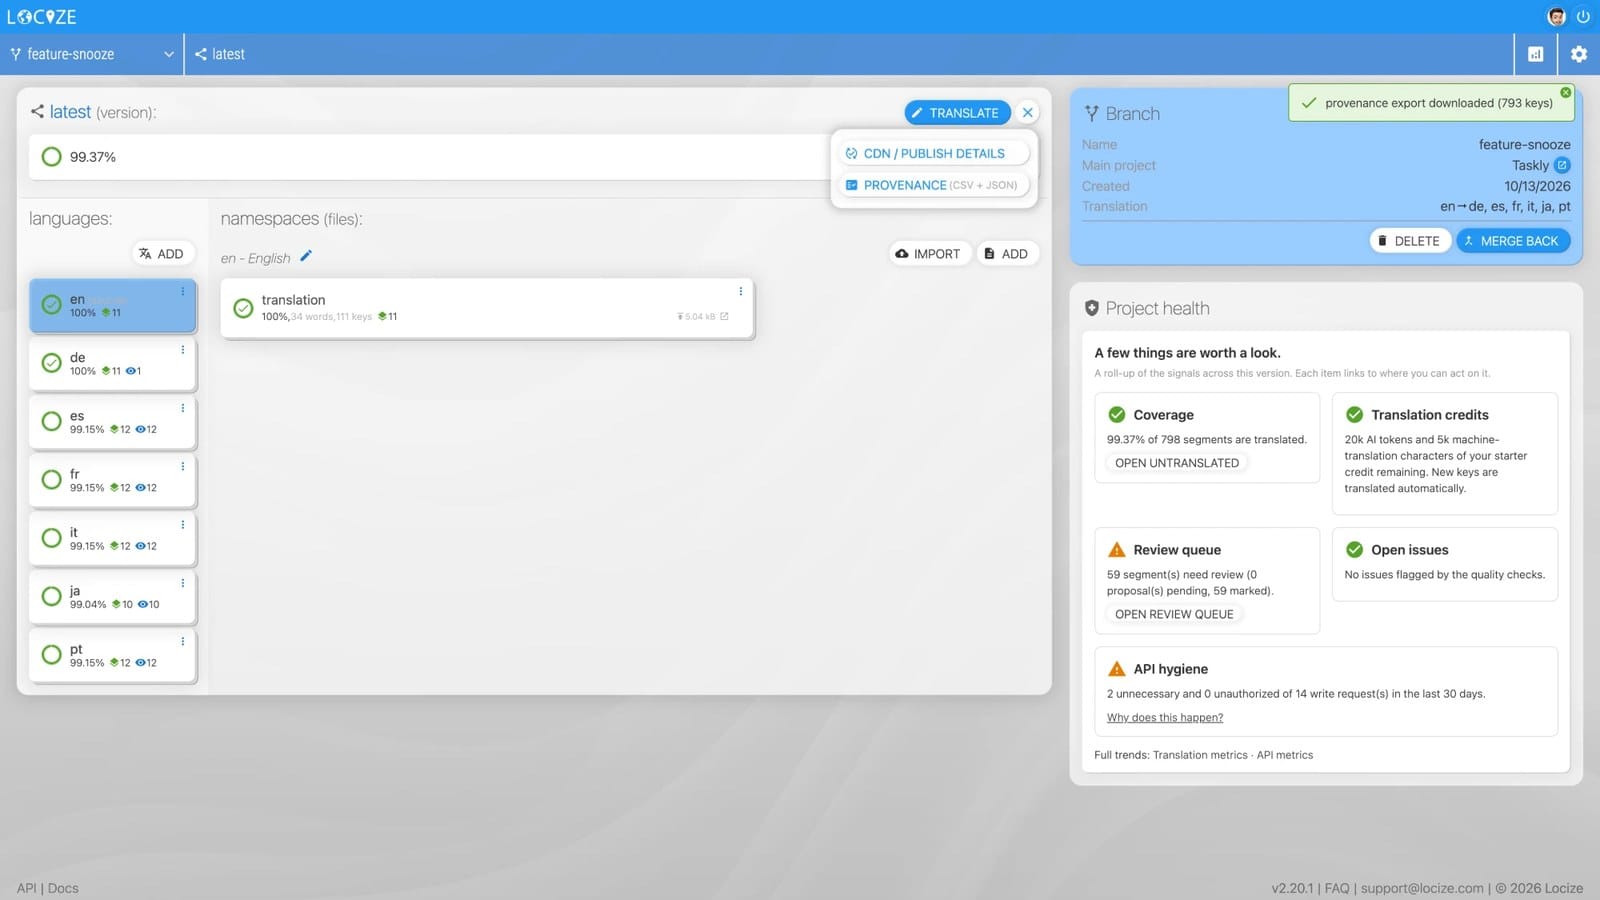
L'export de provenance (vue d'ensemble du projet, menu contextuel de la version, provenance (CSV + JSON)) a attribué un statut de relecture à chaque clé de la branche. Pour les 80 valeurs de la fonctionnalité, les 11 sources anglaises et les 69 traductions :
| Statut de relecture | Valeurs | Ce que c'était |
|---|---|---|
agentEdited | 11 | Les textes sources anglais signalés par l'agent. L'agent a aussi écrit la source, et la trace le dit |
humanReviewed | 9 | Valeurs allemandes confirmées lors de la relecture, chacune avec le score de confiance au moment de la décision |
humanEdited | 1 | « Später heute » |
machineOnly | 59 | Toutes les autres traductions : espagnol, français, italien, japonais et portugais, les révisions de l'agent, et le toast allemand. Chacune nomme l'agent comme déclencheur et reste dans la file de relecture |
Deux lignes du JSON, raccourcies, sans le nom du relecteur :
[{
  "language": "de", "key": "snooze.wakeUp", "value": "Reaktivieren", "quality": "AI",
  "reviewStatus": "humanReviewed",
  "lastHumanAction": {
    "type": "reviewConfirmed", "occurredAt": "2026-10-13T14:26:54.518Z",
    "value": "Reaktivieren", "matchesCurrentValue": true,
    "qeScore": 0.9, "qeScoreReason": "Meaning is clear, though 'Aufwecken' could have been more playful/direct, 'Reaktivieren' is professional."
  }
},
{
  "language": "es", "key": "snooze.wakeUp", "value": "Reactivar", "quality": "AI",
  "reviewStatus": "machineOnly",
  "lastHumanAction": {
    "type": "machineWritten", "occurredAt": "2026-10-13T14:04:58.246Z",
    "by": { "agent": "Claude (OAuth)" }, "quality": "AI"
  },
  "needsReview": true, "qeScore": 1
}]
Les 59 valeurs purement machine sont la partie honnête de la trace : l'agent a corrigé le « Wake up » espagnol et japonais, les scores disent que les correctifs sont bons, et personne qui lit l'espagnol ou le japonais n'a encore regardé. L'export ne l'enjolive pas.
Ce qu'il a fallu, et ce qu'il faut surveiller
- Coût : la traduction et la notation passent par le fournisseur IA du projet : les tokens IA de Locize, ou votre propre clé OpenAI, Gemini ou Mistral. La notation double à peu près les appels IA d'une traduction ; la revérification des 10 valeurs révisées a coûté 1 746 tokens.
- Seuil : à 0,7, rien n'a été envoyé en relecture lors de cet essai, car les chaînes d'interface courtes avec contexte obtiennent des scores élevés. Si vous voulez que tout passe devant une personne pour certaines langues, activez-y les propositions de relecture et faites passer
autoTranslateReview: trueàreport_missing_keyspar l'agent : les traductions automatiques déclenchées via MCP ou l'API ne deviennent des propositions qu'avec cette option. - Publication : la version de développement a publié chaque étape automatiquement. Livrez en production depuis une version distincte après relecture ; le guide du workflow article 50 couvre la configuration de la relecture et explique pourquoi la relecture doit être la dernière intervention.
- Les écritures de l'agent sont étiquetées : les écritures via le serveur MCP portent la marque de l'agent dans l'historique (le nom du client qui s'est connecté, « Claude (OAuth) » dans notre essai), si bien que l'export ne les présente pas comme celles d'une personne.
Essayez-le sur votre projet
- Connectez le serveur MCP à votre agent.
- Dans les réglages du projet, activez la traduction automatique, Quality Estimation et le Review AI workflow.
- Demandez à l'agent de construire la fonctionnalité sur une branche, de signaler les clés avec une phrase de contexte chacune, de récupérer les scores et les justifications, et de corriger ce qu'il peut avant que vous ne regardiez.
- Relisez dans l'éditeur, puis téléchargez l'export de provenance.
Si votre agent écrit déjà vos chaînes, c'est le chemin le plus court pour voir ce qu'il livre. Créez un projet gratuit, connectez le serveur MCP, et faites passer la prochaine fonctionnalité par lui.
Questions fréquentes
Comment laisser Claude Code ou Cursor localiser une fonctionnalité avec Locize ?
Connectez le serveur MCP de Locize, laissez l'agent écrire le code avec des appels t() et signaler les nouvelles clés avec report_missing_keys et une phrase de contexte par clé. Avec la traduction automatique activée, les clés reviennent dans chaque langue cible ; avec Quality Estimation activée, chaque traduction IA reçoit un score de confiance et une justification que l'agent lit avec get_translations et raw: true. Une branche tient les chaînes à l'écart du projet principal jusqu'à ce que vous la fusionniez, après relecture.
Quality Estimation détecte-t-elle toutes les mauvaises traductions ? Non. Elle note chaque chaîne isolément, donc elle manque l'incohérence entre les clés et le code qui construit des phrases à partir de morceaux traduits. Dans notre essai, aucune des 69 traductions IA n'a obtenu moins de 0,7, les justifications désignaient malgré tout les chaînes les plus faibles, et la relecture a tout de même modifié une chaîne notée 1,0. Quality Estimation décide où une personne regarde en premier ; elle ne remplace pas ce regard.
Que montre l'export de provenance pour les traductions écrites par un agent IA ? Le texte que l'agent a poussé comme sortie IA est indiqué comme sortie machine, avec l'agent nommé comme déclencheur ; le texte qu'une personne a confirmé, comme relu par un humain ; le texte qu'une personne a modifié, comme modifié par un humain. Les écritures et confirmations de l'agent qui ne sont pas déclarées comme sortie machine sont indiquées comme agentEdited et agentConfirmed, jamais comme l'action d'une personne.
Pourquoi l'agent signale-t-il des clés au lieu de modifier les fichiers de langue ? Parce que les fichiers n'ont ni mémoire ni trace. Les clés signalées sont traduites avec le glossaire et le guide de style comme contexte, notées, gardées par défaut dans la file de relecture jusqu'à ce qu'une personne les confirme, et chaque action est consignée dans l'historique.
Les traductions IA sont-elles mises en ligne avant que quiconque les relise ?
Seulement là où vous le permettez. Dans notre essai, la version de développement publiait automatiquement, ce qui est souhaitable pendant le développement. La production est une version distincte que vous publiez après relecture. Ou bien vous activez les propositions de relecture pour une langue et faites passer autoTranslateReview: true par l'agent lorsqu'il signale les clés, de sorte que la valeur en ligne ne change que lorsqu'une personne accepte.
Fatigué de gérer vos traductions à la main ?
Locize est le backend de gestion de traductions créé par l'équipe i18next : diffusion CDN, traduction IA, édition in-context, sans redéploiement.
Démarrez votre essai gratuit de 14 jours