
Ein Coding-Agent lokalisiert ein Feature: Konfidenzwerte, Review und die Aufzeichnung, Schritt für Schritt
Coding-Agent-Lokalisierung heisst, dass der KI-Assistent, der Ihr Feature schreibt, auch dessen Strings verdrahtet: Er fügt die t()-Aufrufe hinzu, meldet die neuen Keys und bekommt Übersetzungen zurück. Spannend ist, was danach passiert. Wir haben das einmal echt laufen lassen, mit unserer Demo-App Taskly: Claude Code hat eine Snooze-Funktion hinzugefügt, elf Keys über MCP an Locize gemeldet und sie etwa elf Sekunden später in sechs Sprachen zurückbekommen, jede Übersetzung mit einem Konfidenzwert und einer Begründung. Dieser Beitrag zeigt jeden Schritt mit dem tatsächlichen Output: was die Konfidenzwerte erkannt haben, was sie übersehen haben, was der Agent selbst behoben hat, was das Review trotzdem noch geändert hat und was die Aufzeichnung am Ende sagt.
Das Warum hinter diesem Muster (und wann Sie es überspringen sollten) steht in Wenn Coding-Agents Ihre App übersetzen. Hier geht es um das Wie.
- 11 Keys vom Agenten gemeldet, 69 KI-Übersetzungen zurück in 6 Sprachen (Deutsch, Spanisch, Französisch, Italienisch, Japanisch, Portugiesisch), etwa 11 Sekunden von der Meldung bis zur Veröffentlichung, Bewertung inklusive.
- 0 von 69 lagen unter dem Standard-Schwellenwert von 0,7 für das Review. Der niedrigste Konfidenzwert (0,7) und beide Werte von 0,8 gingen an denselben String: "Wake up".
- Was die Konfidenzwerte übersehen haben: ein deutscher Begriff, der über Keys hinweg uneinheitlich verwendet wurde, ein Fehler in der Art, wie der Code des Agenten einen Satz zusammengesetzt hat, und ein deutscher String mit 1,0, den das Review trotzdem umgeschrieben hat. Das Erste hat der Agent gefunden, die anderen beiden das Review.
- Die Aufzeichnung: Jeder Wert endet mit einem Review-Status im Provenance-Export (hier: 9 menschlich geprüft, 1 menschlich bearbeitet, 11 vom Agenten geschrieben, 59 maschinelle Ausgabe, die noch niemand geprüft hat), "eine Person hat das geprüft" ist also etwas, das Sie pro String vorzeigen können, und das Fehlen davon ebenso.
Das Setup
- Die App: Taskly, eine kleine To-do-App mit Vite, React und TypeScript, internationalisiert mit i18next und react-i18next. Englische Quelle, sechs Zielsprachen im Locize-Projekt (das Repository bringt fünf mit; Portugiesisch wurde in Locize hinzugefügt), ein Namespace mit etwa hundert Keys, ein Styleguide mit informellem Ton und ein Glossar, das bisher nur den Produktnamen schützt.
- Der Agent: Claude Code in der Claude-Desktop-App, mit dem Locize-MCP-Server als Connector (
https://mcp.locize.app, Anmeldung über OAuth). In der Claude-Code-CLI ist derselbe Serverclaude mcp add --transport http locize https://mcp.locize.app, danach/mcpzum Anmelden. Cursor und andere MCP-Clients funktionieren genauso. - Die Projekteinstellungen: automatische Übersetzung an, Quality Estimation an, dazu der Review AI workflow, der KI-Übersetzungen mit niedriger Konfidenz in Review-Vorschläge leitet.
- Ein Branch: Der Agent hat für das Feature einen Branch des Projekts angelegt (
create_branch), damit die neuen Strings aus dem Hauptprojekt herausbleiben, bis sie geprüft und gemergt sind. Ein Branch übernimmt beim Anlegen die automatische Übersetzung, Quality Estimation und den Review AI workflow vom Projekt.
Schritt 1: Kontext vor dem Entwurf
Bevor er einen einzigen String schrieb, fragte der Agent das Projekt nach seinen Regeln: get_styleguide lieferte tone: informal, audience: personal use, und get_glossary lieferte einen Begriff, den Produktnamen, der in jeder Sprache als "Taskly" erhalten bleiben soll. Nichts zu "snooze". Diese Lücke wird später wichtig.
Schritt 2: Code schreiben, Keys melden
Das Feature: eine Aufgabe auf später heute, morgen früh oder nächste Woche zurückstellen, anzeigen, wann sie zurückkommt, zurückgestellte Aufgaben in der Seitenleiste zählen und eine Aufgabe vorzeitig zurückholen. Der Agent schrieb die Komponente mit t()-Aufrufen und verschachtelten Keys unter snooze:
const OPTIONS = ['laterToday', 'tomorrowMorning', 'nextWeek'] as const

<button onClick={() => setOpen(true)}>{t('snooze.action')}</button>
<h3>{t('snooze.menuTitle')}</h3>
{OPTIONS.map((o) => (
  <button key={o} onClick={() => snooze(task, o)}>{t(`snooze.${o}`)}</button>
))}
<span>{t('snooze.snoozedUntil', { date: formatShortDate(task.snoozedUntil) })}</span>
<span>{t('snooze.count', { count: snoozedCount })}</span>
<button onClick={() => wake(task)}>{t('snooze.wakeUp')}</button>
{snoozed.length === 0 && <p>{t('snooze.empty')}</p>}

// after snoozing
toast(t('snooze.toast', { title: task.title, when: t(`snooze.${o}`).toLowerCase() }))
Dann meldete er die elf englischen Keys mit report_missing_keys, jeden mit einem Satz Kontext für den Übersetzer (Mensch oder KI):
{
  "snooze.wakeUp": {
    "value": "Wake up",
    "context": { "text": "Button on a snoozed task. Brings the task back to the active list right now." }
  },
  "snooze.toast": {
    "value": "Snoozed “{{title}}”. We’ll nudge you {{when}}.",
    "context": { "text": "Toast after snoozing a task. {{title}} is the task title. {{when}} is one of the snooze option labels in lower case, for example: tomorrow morning." }
  }
}
report_missing_keys legt nur Keys an, es überschreibt nie. Es genügt, an die Referenzsprache zu melden: Ab dort übernimmt die automatische Übersetzung.
Schritt 3: Was zurückkam
Etwa elf Sekunden später waren alle sechs Sprachen übersetzt, bewertet und (weil die Entwicklungsversion automatisch veröffentlicht) auf dem CDN. 69 Werte aus 11 englischen Keys, weil die Pluralformen der jeweiligen Sprache folgen, nicht der englischen Quelle:
| Sprache | Werte | Pluralformen von snooze.count |
|---|---|---|
| Deutsch | 11 | one, other |
| Spanisch, Französisch, Italienisch, Portugiesisch | je 12 | one, many, other |
| Japanisch | 10 | nur other |
Der Agent hat zwei englische Formen geschrieben. Französisch, Italienisch, Spanisch und Portugiesisch haben eine dritte CLDR-Kategorie, many (verwendet für sehr grosse Zahlen wie eine Million), und Japanisch hat nur eine einzige. Locize hat die Formen angelegt, die jede Sprache braucht; ein Agent, der Sprachdateien von Hand schreibt, muss das selbst wissen.
Schritt 4: Die Konfidenzwerte
Jede KI-Übersetzung erhielt einen Konfidenzwert zwischen 0 und 1 und eine Begründung in einem Satz. Seit dem 13. Oktober 2026 kann der Agent beides mit get_translations und raw: true lesen (qeScore, qeScoreReason), er muss also nicht warten, bis eine Person den Editor öffnet.
| Konfidenz | Werte |
|---|---|
| 1,0 | 53 |
| 0,95 | 4 |
| 0,9 | 9 |
| 0,8 | 2 |
| 0,7 | 1 |
| unter 0,7 | 0 |
Nichts wurde in Review-Vorschläge geleitet: Das passiert unter dem Schwellenwert (standardmässig 0,7) oder wenn der Evaluator ein schwerwiegendes Problem markiert, und beides trat nicht ein. Die Begründungen zeigten trotzdem auf die schwächsten Strings:
| Key | Sprache | Übersetzung | Konfidenz | Begründung des Evaluators (übersetzt) |
|---|---|---|---|---|
snooze.wakeUp | Spanisch | Despertar | 0,7 | Wörtliche Übersetzung von "Wake up"; "Reactivar" ist im Aufgabenmanagement idiomatischer |
snooze.wakeUp | Deutsch | Aufwecken | 0,8 | Wörtliche Übersetzung; "Aktivieren" oder "Wiederherstellen" passt besser in eine Aufgaben-UI |
snooze.wakeUp | Japanisch | 起こす | 0,8 | Etwas unnatürlich; 今すぐ戻す passt in einer Aufgaben-App besser |
snooze.action | Deutsch | Schlummern | 0,9 | Technisch korrekt, aber "Zurückstellen" ist im Aufgabenmanagement idiomatischer |
Französisch, Italienisch und Portugiesisch haben "Wake up" ohne Hilfe richtig getroffen (Réactiver und Riattiva mit 1,0, Retomar mit 0,9). Dort hat der Kontextsatz seine Arbeit gemacht; in den anderen drei Sprachen kam der Button trotzdem so heraus, als würde man jemanden aufwecken.
Schritt 5: Der Agent überarbeitet und findet, was die Konfidenzwerte übersehen haben
Beim Lesen der Konfidenzwerte fand der Agent etwas, das kein einzelner Wert zeigt: Das Deutsche verwendete zwei Begriffe für dieselbe Aktion. Fünf Keys sagten "Schlummern", der Toast sagte "pausiert", und der Evaluator hatte diesen Toast mit 0,9 bewertet, "hohe Qualität". Quality Estimation bewertet einen String nach dem anderen, Konsistenz über Keys hinweg kann sie also nicht sehen.
Die KI-Übersetzung schwankte auch zwischen Läufen. Wir hatten dieselben Keys mit demselben Kontext schon einmal gemeldet (die Keys wurden entfernt und unter den verschachtelten Namen erneut gemeldet): Der erste Lauf wählte "Zurückstellen", der zweite "Schlummern". Keines davon ist falsch; beides auszuliefern schon. Ohne Glossareintrag schwankt der Entwurf von Lauf zu Lauf, genau der Fehlermodus, den der Kategorie-Beitrag beschreibt, und der Grund, warum der Glossareintrag weiter unten der eigentliche Fix ist.
Der Agent schickte seine Überarbeitungen mit update_translations und quality: "AI": Deutsch durchgehend "Zurückstellen" (auch im Toast), und "Wake up" als Reaktivieren, Reactivar und 今すぐ戻す. Als KI-Output deklariert, bleiben die Überarbeitungen in der Review-Warteschlange, statt als freigegeben zu gelten. Dann startete er einen KI-Review-Lauf (start_ai_review), um sie neu bewerten zu lassen, denn jede Bearbeitung entfernt den alten Konfidenzwert:
- 10 Werte geprüft, 10 bewertet, 0 angezweifelt, 1746 KI-Tokens.
- Deutsch erreicht jetzt durchgehend 1,0, ausser Reaktivieren (0,9); Spanisch Reactivar 1,0, Japanisch 今すぐ戻す 0,9.
- Eine ehrliche Fussnote: Im zweiten Durchgang merkte der Evaluator an, "Aufwecken" wäre "verspielter/direkter" gewesen. Im ersten Durchgang hatte er dasselbe Wort eine wörtliche Übersetzung genannt. Ein Evaluator ist eine Weiche, kein Richter.
Der Fix für die Ursache ist ein Glossareintrag für "snooze" pro Sprache. Der MCP-Server liest das Glossar nur, das Hinzufügen des Begriffs ist also ein Schritt für eine Person, und zwar der richtige: Terminologie ist eine Entscheidung, kein Entwurf.
Schritt 6: Das Review
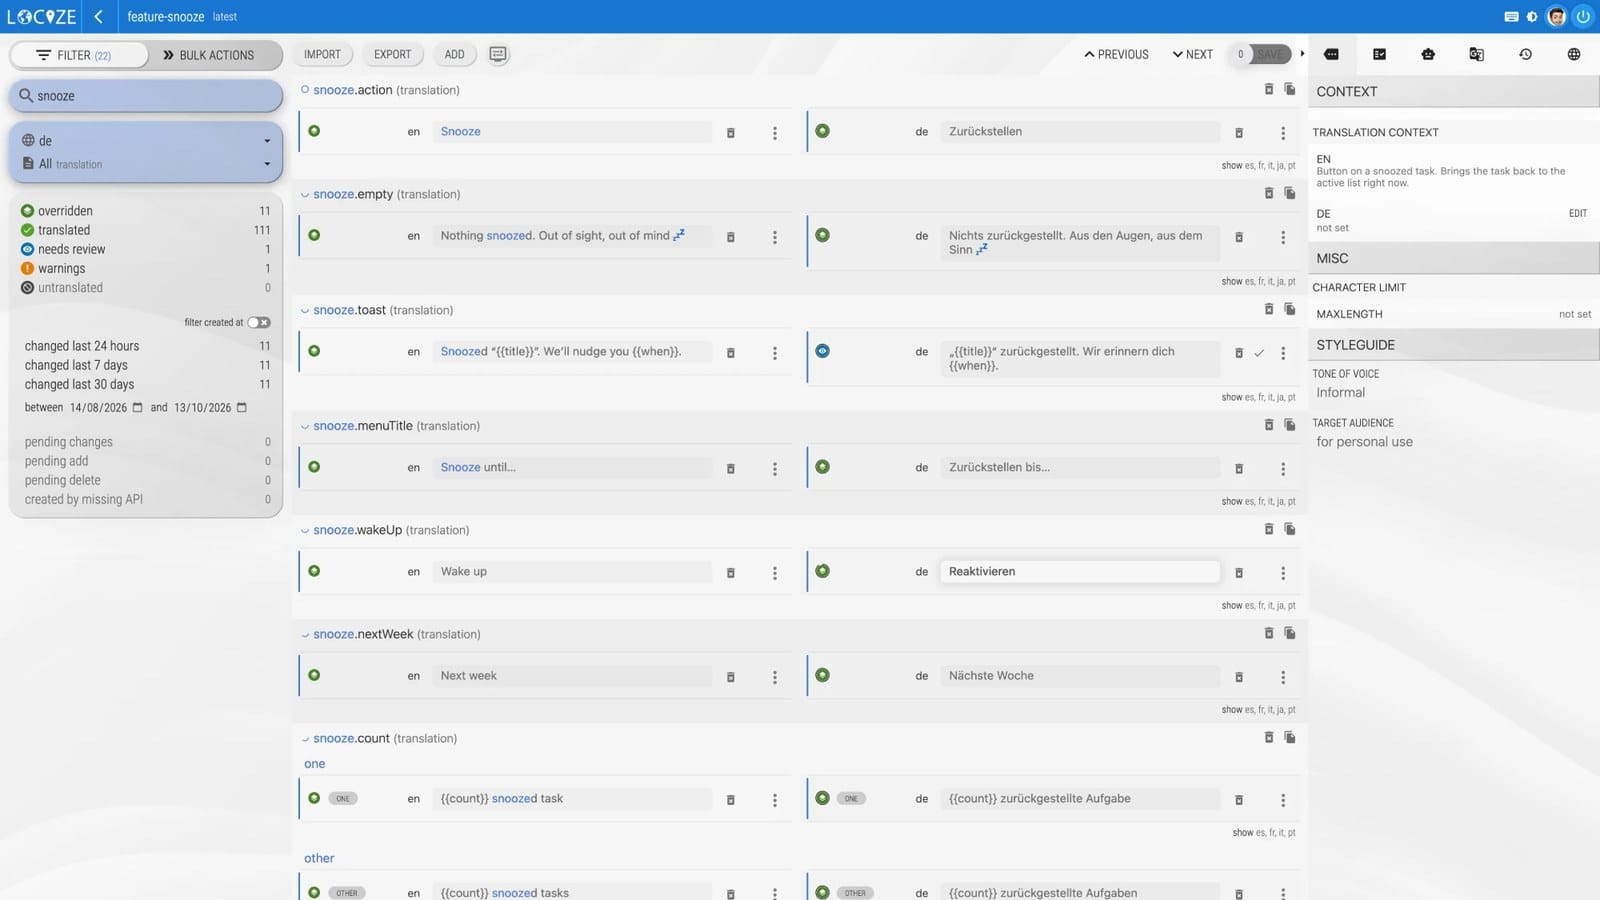
Die deutschen Werte gingen durch die Review-Warteschlange des Editors: jeder neben seiner Quelle, dem Kontextsatz des Agenten und dem Styleguide. Neun wurden unverändert bestätigt. Zwei Dinge waren sowohl am Evaluator als auch am Agenten vorbeigekommen:
- Ein String mit 1,0, "perfekte Übersetzung": Aus "Later today" war "Heute später" geworden. Korrektes Deutsch, aber als Menüoption liest sich "Später heute" natürlicher, also hat das Review den Wert geändert. Die Bearbeitung hat den Konfidenzwert entfernt, denn ein Konfidenzwert beschreibt nur den Text, für den er berechnet wurde.
- Ein Fehler im Code des Agenten selbst. Der Toast setzt ein übersetztes Options-Label in Kleinbuchstaben in einen Satz ein: in Ordnung für "tomorrow morning", falsch im Deutschen, wo Substantive grossgeschrieben werden: "Wir erinnern dich nächste woche." Kein Konfidenzwert kann das sehen, weil jeder String für sich korrekt ist. Der Fix gehört in den Code: ein Toast pro Option, mit i18next-Kontext statt String-Verkettung.
// before: toast(t('snooze.toast', { title, when: t(`snooze.${o}`).toLowerCase() }))
toast(t('snooze.toast', { context: o, title: task.title }))
// keys: snooze.toast_laterToday, snooze.toast_tomorrowMorning, snooze.toast_nextWeek
Der deutsche Toast blieb unbestätigt: Sein Text ist in Ordnung, aber der Key wird demnächst durch die Kontext-Keys oben ersetzt.
Das ist die Arbeitsteilung, die der Lauf nahelegt: Der Evaluator ordnet einzelne Strings ein, der Agent prüft die Konsistenz über den ganzen Batch und behebt, worauf man ihn hinweist, und das Review fängt ab, was isoliert richtig und im Einsatz falsch ist.
Schritt 7: Die Aufzeichnung
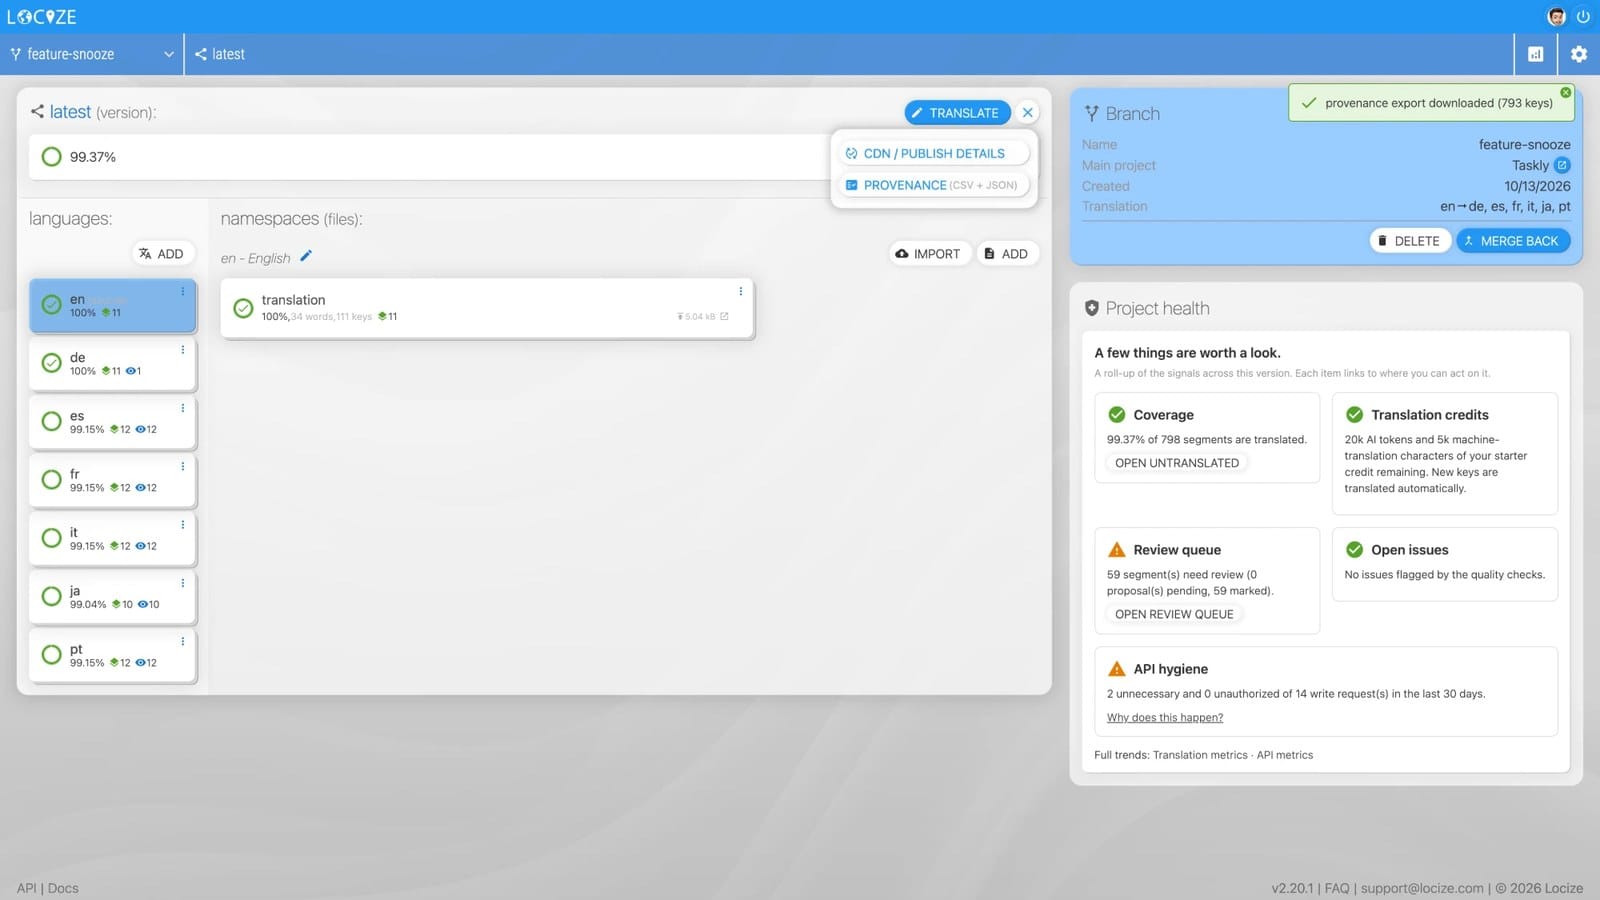
Der Provenance-Export (Projektübersicht, Kontextmenü der Version, provenance (CSV + JSON)) gab jedem Key des Branches einen Review-Status. Für die 80 Werte des Features, die 11 englischen Quelltexte und die 69 Übersetzungen:
| Review-Status | Werte | Was es war |
|---|---|---|
agentEdited | 11 | Die englischen Quelltexte, die der Agent gemeldet hat. Der Agent hat auch die Quelle geschrieben, und die Aufzeichnung sagt das |
humanReviewed | 9 | Deutsche Werte, im Review bestätigt, jeweils mit dem Konfidenzwert zum Zeitpunkt der Entscheidung |
humanEdited | 1 | "Später heute" |
machineOnly | 59 | Jede andere Übersetzung: Spanisch, Französisch, Italienisch, Japanisch und Portugiesisch, die Überarbeitungen des Agenten und der deutsche Toast. Jeder Eintrag nennt den Agenten als Auslöser und bleibt in der Review-Warteschlange |
Zwei Zeilen aus dem JSON, gekürzt, ohne den Namen des Reviewers:
[{
  "language": "de", "key": "snooze.wakeUp", "value": "Reaktivieren", "quality": "AI",
  "reviewStatus": "humanReviewed",
  "lastHumanAction": {
    "type": "reviewConfirmed", "occurredAt": "2026-10-13T14:26:54.518Z",
    "value": "Reaktivieren", "matchesCurrentValue": true,
    "qeScore": 0.9, "qeScoreReason": "Meaning is clear, though 'Aufwecken' could have been more playful/direct, 'Reaktivieren' is professional."
  }
},
{
  "language": "es", "key": "snooze.wakeUp", "value": "Reactivar", "quality": "AI",
  "reviewStatus": "machineOnly",
  "lastHumanAction": {
    "type": "machineWritten", "occurredAt": "2026-10-13T14:04:58.246Z",
    "by": { "agent": "Claude (OAuth)" }, "quality": "AI"
  },
  "needsReview": true, "qeScore": 1
}]
Die 59 rein maschinellen Werte sind der ehrliche Teil der Aufzeichnung: Der Agent hat das spanische und das japanische "Wake up" korrigiert, die Konfidenzwerte sagen, die Korrekturen sind gut, und noch niemand, der Spanisch oder Japanisch liest, hat hingeschaut. Der Export rundet das nicht auf.
Was es gekostet hat, und worauf Sie achten sollten
- Kosten: Übersetzung und Bewertung laufen über den KI-Anbieter des Projekts: KI-Tokens von Locize oder Ihr eigener OpenAI-, Gemini- oder Mistral-Key. Die Bewertung verdoppelt ungefähr die KI-Aufrufe eines Übersetzungslaufs; die Neuprüfung von 10 überarbeiteten Werten kostete 1746 Tokens.
- Schwellenwert: Bei 0,7 wurde in diesem Lauf nichts weitergeleitet, weil kurze UI-Strings mit Kontext hoch bewertet werden. Wenn Sie für manche Sprachen alles einer Person vorlegen wollen, aktivieren Sie dort Review-Vorschläge und lassen den Agenten
autoTranslateReview: trueanreport_missing_keysübergeben: Automatische Übersetzungen, die über MCP oder die API ausgelöst werden, werden nur mit diesem Flag zu Vorschlägen. - Veröffentlichen: Die Entwicklungsversion hat jeden Schritt automatisch veröffentlicht. Liefern Sie nach dem Review aus einer separaten Version in die Produktion aus; der Leitfaden zum Artikel-50-Workflow behandelt das Review-Setup und warum das Review der letzte Eingriff sein muss.
- Schreibvorgänge von Agents sind gekennzeichnet: Schreibvorgänge über den MCP-Server tragen die Markierung des Agenten in der Historie (den Namen des Clients, der sich angemeldet hat, in unserem Lauf "Claude (OAuth)"), deshalb weist der Export sie nicht als die einer Person aus.
Probieren Sie es an Ihrem Projekt aus
- Verbinden Sie den MCP-Server mit Ihrem Agenten.
- Aktivieren Sie in den Projekteinstellungen die automatische Übersetzung, Quality Estimation und den Review AI workflow.
- Bitten Sie den Agenten, das Feature auf einem Branch zu bauen, die Keys mit je einem Kontextsatz zu melden, die Konfidenzwerte und Begründungen zurückzulesen und zu beheben, was er kann, bevor Sie hinschauen.
- Prüfen Sie im Editor und laden Sie danach den Provenance-Export herunter.
Wenn Ihr Agent bereits Ihre Strings schreibt, ist das der kürzeste Weg, um zu sehen, was er ausliefert. Erstellen Sie ein kostenloses Projekt, verbinden Sie den MCP-Server und lassen Sie das nächste Feature hindurchlaufen.
Häufig gestellte Fragen
Wie lasse ich Claude Code oder Cursor ein Feature mit Locize lokalisieren?
Verbinden Sie den Locize-MCP-Server, lassen Sie den Agenten den Code mit t()-Aufrufen schreiben und die neuen Keys mit report_missing_keys und einem Kontextsatz pro Key melden. Mit aktivierter automatischer Übersetzung kommen die Keys in jeder Zielsprache zurück; mit aktivierter Quality Estimation erhält jede KI-Übersetzung einen Konfidenzwert und eine Begründung, die der Agent mit get_translations und raw: true liest. Ein Branch hält die Strings aus dem Hauptprojekt heraus, bis Sie ihn nach dem Review mergen.
Erkennt Quality Estimation jede schlechte Übersetzung? Nein. Sie bewertet jeden String für sich und übersieht deshalb Inkonsistenz über Keys hinweg und Code, der Sätze aus übersetzten Teilen zusammensetzt. In unserem Lauf lag keine der 69 KI-Übersetzungen unter 0,7, die Begründungen zeigten trotzdem auf die schwächsten Strings, und das Review änderte dennoch einen String mit 1,0. Quality Estimation entscheidet, wo eine Person zuerst hinschaut; sie ersetzt das Hinschauen nicht.
Was zeigt der Provenance-Export für Übersetzungen, die ein KI-Agent geschrieben hat? Text, den der Agent als KI-Output geschickt hat, wird als maschinelle Ausgabe mit dem Agenten als Auslöser ausgewiesen; Text, den eine Person bestätigt hat, als menschlich geprüft; Text, den eine Person geändert hat, als menschlich bearbeitet. Schreibvorgänge und Bestätigungen eines Agenten, die nicht als maschinelle Ausgabe deklariert sind, werden als agentEdited und agentConfirmed ausgewiesen, nie als Aktion einer Person.
Warum meldet der Agent Keys, statt die Sprachdateien zu bearbeiten? Weil Dateien kein Gedächtnis und keine Aufzeichnung haben. Gemeldete Keys werden mit Glossar und Styleguide als Kontext übersetzt, bewertet und standardmässig in der Review-Warteschlange gehalten, bis eine Person sie bestätigt, und jede Aktion wird in der Historie festgehalten.
Gehen KI-Übersetzungen live, bevor jemand sie geprüft hat?
Nur dort, wo Sie es zulassen. Die Entwicklungsversion hat in unserem Lauf automatisch veröffentlicht, und genau das wollen Sie während der Entwicklung. Produktion ist eine separate Version, die Sie nach dem Review veröffentlichen. Oder Sie aktivieren Review-Vorschläge für eine Sprache und lassen den Agenten beim Melden der Keys autoTranslateReview: true mitgeben, sodass sich der Live-Wert erst ändert, wenn eine Person annimmt.
Übersetzungen noch von Hand verwalten?
Locize ist das Translation-Management-Backend vom i18next-Team: CDN-Auslieferung, KI-Übersetzung, In-Context-Editing, keine Redeploys.
14 Tage kostenlos testen