In questa pagina
Il finale onesto della maggior parte dei dibattiti "compriamo uno strumento di traduzione?" nel 2026 è: passate il JSON in un LLM nella CI e andate avanti. È veloce, quasi gratis, e per una piccola app produce qualcosa di davvero usabile. L’abbiamo detto noi stessi, pubblicamente, nella nostra pagina perché non usare solo l’IA?
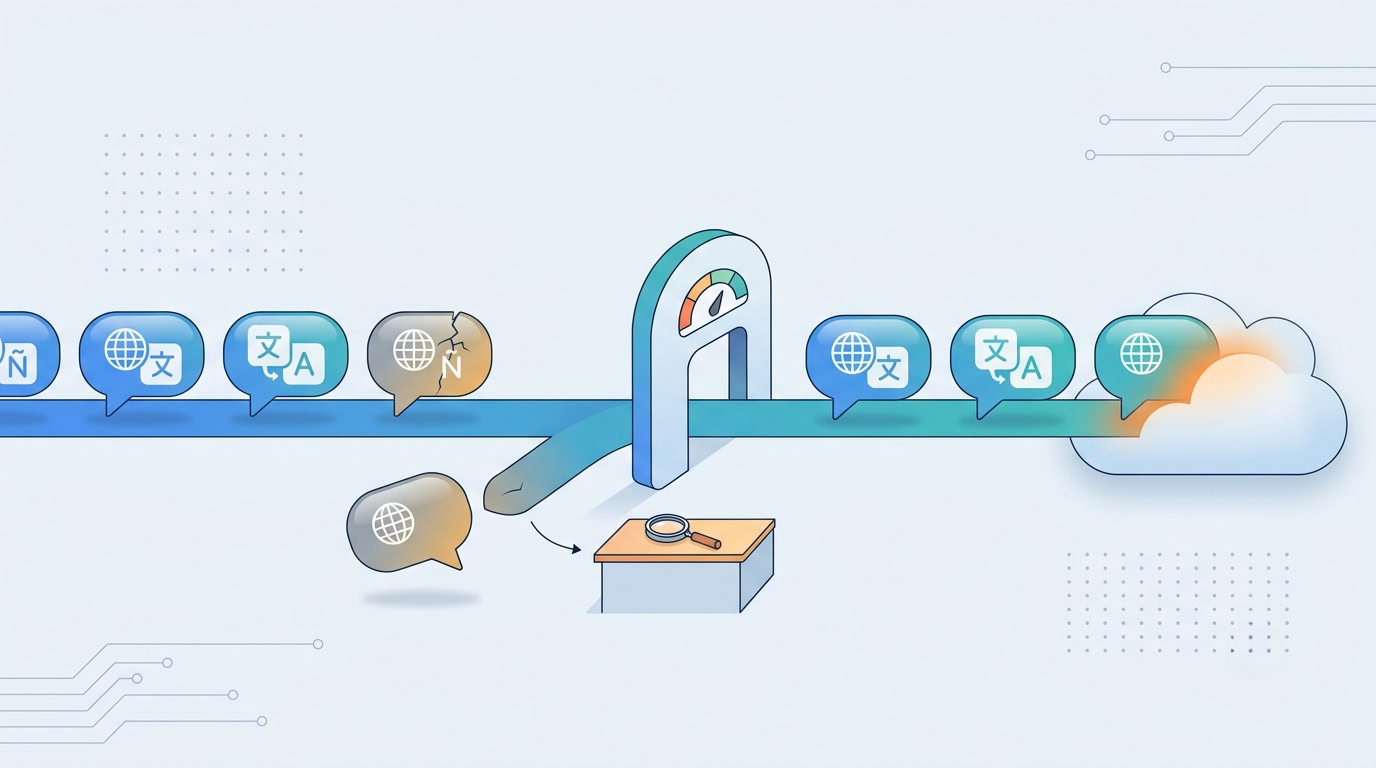
Questo post parla di ciò che viene dopo, perché un dopo c’è. Le pipeline di traduzione solo-IA non falliscono rumorosamente il primo giorno. Falliscono in silenzio, mesi dopo, in una manciata di modi specifici e prevedibili. Se ne gestite una, questa è la guida sul campo ai modi di rottura, e al percorso di crescita che li risolve senza buttare via la pipeline.
- Cosa si rompe: deriva terminologica, salti di registro, casi limite plurali/ICU, stringhe legali pubblicate senza revisione, e nessuna risposta a "chi l’ha approvata?"
- Perché i prompt non bastano: coerenza e tracciabilità sono problemi di dati e workflow. Una chiamata al modello senza stato non ha glossario, non ricorda le decisioni del mese scorso e non ha audit trail.
- Il percorso di crescita: tenete il vostro LLM (chiave vostra), aggiungete il contesto glossario + styleguide, valutate ogni traduzione (Quality Estimation), mandate in revisione umana solo le stringhe incerte, consegnate via CDN.
- Quando non crescere: progetto piccolo, poche lingue, nessun utente esterno. Lì il solo-IA è una scelta legittima.
- Compliance: l’articolo 50 dell’EU AI Act è in vigore dal 2 agosto 2026. Un workflow di revisione umana documentato è la via dell’esenzione per il testo tradotto, e l’export di provenance ne è l’evidenza.
Cosa si rompe davvero
Deriva terminologica. Ogni chiamata al modello è senza stato. Nulla ricorda che "Drive" è il nome del vostro prodotto, che "Abo" era la parola scelta per subscription in tedesco, o che il vostro spagnolo usa "tú" e non "usted". Su centinaia di stringhe e mesi di esecuzioni incrementali, lo stesso concetto accumula tre o quattro rese diverse. Gli utenti se ne accorgono prima di voi, perché vedono le schermate una accanto all’altra.
Salti di registro e di voce. Parente del precedente, ma più subdolo: il registro cambia a metà app. Una schermata dà del lei, la successiva del tu. Nelle lingue in cui questa distinzione è grammaticale (tedesco, francese, giapponese, coreano), un registro incoerente si legge come un difetto, non come una scelta di stile.
Plurali e casi limite ICU. L’inglese ha due forme plurali; polacco e arabo ne hanno di più, con regole che un modello applica bene in isolamento e in modo incoerente in blocco. Le variabili interpolate nelle stringhe ICU MessageFormat si rovinano facilmente in un giro batch, e un placeholder rotto non è un problema di stile, è un bug a runtime.
Stringhe che portano rischio. Note legali, formulazioni mediche, condizioni di prezzo, etichette di accessibilità. Sono esattamente le stringhe per cui "il modello di solito ha ragione" non è un livello di qualità accettabile, ed esattamente quelle che una pipeline batch senza revisione pubblica come qualsiasi altra stringa.
Nessuna risposta a "chi l’ha approvata?" La prima volta che un cliente, una legale o un auditor chiede perché l’app diceva quel che diceva in italiano, una pipeline solo-IA ha una sola risposta: un commit git firmato da un bot. Nessun revisore, nessuna traccia decisionale, nessun punteggio di qualità. Per i team toccati dagli obblighi di trasparenza dell’AI Act europeo (l’articolo 50, in vigore dal 2 agosto 2026), la domanda non è più ipotetica; il nostro check di conformità Articolo 50 spiega cosa fa scattare (e cosa no) il contenuto tradotto automaticamente.
L’esempio pubblico dell’intero schema è arrivato a novembre 2025, quando Mozilla ha spostato i contenuti di supporto alla localizzazione IA-first e la storica comunità di volontari giapponese si è dimessa in risposta. La critica più condivisa di quel lunghissimo thread non era "ha tradotto l’IA". Era che nulla faceva rispettare terminologia e linee guida di stile, e i madrelingua trovavano il risultato peggio di niente. È il modo di rottura in una frase: non la qualità media di traduzione, ma la varianza di qualità non governata.
Perché prompt migliori non bastano
La correzione istintiva è il prompt engineering: incollate il glossario nel prompt, aggiungete istruzioni di stile, rilanciate. Aiuta, ed è anche un tapis roulant:
- Il contesto non scala. Glossario, regole di stile e decisioni passate crescono; le finestre di contesto e l’attenzione non stanno dietro a "ecco 400 decisioni terminologiche, applicale tutte in modo coerente su 3.000 stringhe".
- Non c’è memoria tra le esecuzioni. Le correzioni accurate del mese scorso non sono dati di addestramento per il batch di questo mese. Le stringhe corrette regrediscono quando una stringa sorgente cambia e viene ritradotta.
- Manca comunque un cancello. Anche un prompt perfetto produce output che va in produzione senza revisione. Il problema non è mai stato solo la qualità di traduzione; è che nulla sta tra il modello e la produzione.
La coerenza è un problema di dati (glossario, translation memory), la qualità un problema di misura (punteggio), la tracciabilità un problema di workflow (revisione con cronologia). Nessuno dei tre è un problema di prompt.
Il percorso di crescita: tenete la pipeline, aggiungete il livello
Crescere oltre il solo-IA non significa assumere un’agenzia né abbandonare l’automazione. In concreto, con Locize funziona così; ogni pezzo è incrementale:
- Tenete il vostro modello, dategli contesto. La traduzione automatica gira con la vostra chiave OpenAI, Gemini o Mistral (o col servizio integrato). Il vostro glossario e la vostra styleguide vengono iniettati in ogni prompt, così le decisioni di terminologia e registro che avete già preso valgono automaticamente per ogni stringa futura.
- Valutate tutto. La Quality Estimation valuta ogni traduzione IA da 0 a 1 e segnala problemi concreti. La soglia la scegliete voi (0,7 di default).
- Rivedete solo ciò che merita occhi. Le traduzioni affidabili si salvano subito; quelle incerte vanno nel workflow di revisione, dove un revisore le vede nel contesto dell’app. Le decisioni accetta/rifiuta sono registrate nella cronologia, e l’export di provenance le impacchetta come evidenza CSV + JSON pronta per l’audit.
- Consegnate senza redeploy. Le traduzioni approvate si pubblicano su una CDN globale. La vostra pipeline CI continua a girare; il passaggio "committa il JSON e rideploya per un refuso" sparisce.
L’effetto netto: lo stesso LLM fa lo stesso lavoro, ma la terminologia smette di derivare, le stringhe a rischio passano davanti a occhi umani, e ogni traduzione in produzione sa rispondere a "chi l’ha approvata, e con quanta confidenza?".
2 agosto 2026: l’articolo 50 è in vigore
Dal 2 agosto 2026 si applicano gli obblighi di trasparenza dell’articolo 50 dell’EU AI Act – il Digital Omnibus ha rinviato i capitoli ad alto rischio, non questi. Le linee guida finali della Commissione (20 luglio 2026) hanno chiarito cosa significa per la traduzione: le traduzioni IA fedeli sono esenti dalla marcatura leggibile meccanicamente, ma il testo tradotto dall’IA che informa il pubblico su questioni di interesse pubblico richiede ancora una divulgazione visibile, e proprio quell’obbligo viene meno quando il contenuto è passato per una revisione umana o un controllo editoriale, con una persona fisica o giuridica che detiene la responsabilità editoriale. L’esempio delle stesse linee guida per l’esenzione è una traduzione IA revisionata da un umano – in altre parole, il percorso di crescita qui sopra non è solo igiene di qualità: i passi 2 e 3 sono la via dell’esenzione. L’approfondimento sull’articolo 50 dà il quadro giuridico completo.
Dimostrarlo è la parte che manca alla maggior parte delle pipeline. In Locize l’export di provenance impacchetta l’evidenza in un solo download: aprite il menu contestuale di una versione, lingua o namespace nella panoramica del progetto e scegliete provenance per ottenere un report CSV + JSON con chi ha revisionato, approvato o modificato ogni traduzione e quando, la fonte della traduzione (umano, macchina o IA), il punteggio di confidenza al momento della decisione, e cosa attende ancora revisione. "È passato per una revisione umana" smette di essere un’affermazione e diventa un documento. La guida al workflow Articolo 50 mostra la configurazione end-to-end.
Quando non dovreste crescere
L’onestà vale in entrambe le direzioni. Se portate avanti un progetto personale, traducete in due o tre lingue che potete ricontrollare da soli, e né fatturato né compliance dipendono dai testi, un LLM in CI più JSON in git è un assetto perfettamente sano, e più economico di qualsiasi strumento. I segnali di crescita sono concreti: una lingua che nessuno nel team legge, un traduttore o revisore che non è sviluppatore, un termine che non deve mai variare, una stringa che interessa a una legale, o un reclamo di qualità di un utente che non siete riusciti a rintracciare. La settimana in cui ne compare uno è la settimana in cui il livello di gestione inizia a ripagarsi.
Un modo senza impegno per capire dove siete: trascinate i vostri file di localizzazione nel health check i18n gratuito. Gira interamente nel browser (nulla viene caricato) e mostra le chiavi mancanti, i valori sorgente duplicati e le discrepanze di interpolazione che la vostra pipeline attuale ha già prodotto. Nessun file di localizzazione ancora? Incollate invece il vostro repository GitHub pubblico nel readiness check i18n gratuito: elenca le stringhe ancora hardcoded e l'unico comando che le sistema.
Se più di uno di questi segnali vi suona familiare, iniziate gratis con Locize, collegate la vostra pipeline esistente (la vostra chiave, il vostro modello) e attivate la Quality Estimation per il prossimo batch: vedrete la distribuzione dei punteggi del vostro output IA attuale prima di cambiare qualsiasi altra cosa. La pagina perché non usare solo l’IA? contiene la versione onesta dell’intero compromesso.
Domande frequenti
Perché le mie traduzioni IA sono incoerenti?
Perché ogni richiesta di traduzione è senza stato. Il modello non ricorda come avete tradotto un termine la settimana scorsa, non ha un glossario né una voce di brand definita, così "Drive" diventa tre parole diverse nell’app e il registro formale/informale cambia da una schermata all’altra. Più prompting riduce il fenomeno ma non lo elimina: la coerenza è un problema di dati (glossario e translation memory), non di prompt.
Come aggiungo la revisione alle traduzioni LLM senza perdere l’automazione?
Prima il punteggio, poi la revisione selettiva. La Quality Estimation valuta ogni traduzione IA da 0 a 1; i risultati sopra la soglia vengono salvati subito, quelli incerti o con problemi segnalati passano a un workflow di revisione umana. La pipeline resta completamente automatica per la maggior parte delle stringhe, mentre un umano vede esattamente quelle che meritano occhi, nel contesto dell’app, con cronologia accetta/rifiuta.
Mi serve ancora un TMS se a tradurre è l’IA?
Per un progetto piccolo con poche lingue e senza utenti esterni: onestamente, spesso no. Il bisogno di gestione arriva con la scala: più lingue, editor non sviluppatori, terminologia che deve restare coerente, stringhe legali o di compliance, e la domanda "chi ha approvato questa traduzione?". A quel punto il TMS non compete con l’IA, la gestisce: stesso LLM, più contesto di glossario, punteggio di qualità, revisione e delivery via CDN.
Cos’è la Quality Estimation per la traduzione automatica?
La Quality Estimation (QE) è un punteggio automatico di quanta fiducia potete dare a una traduzione automatica o IA, senza che un umano la legga prima. Locize valuta ogni traduzione IA da 0 a 1 e segnala problemi concreti; impostate voi la soglia (0,7 di default) che decide cosa viene salvato subito e cosa va in revisione umana. "Fidarsi del modello" diventa un cancello misurabile e regolabile.
Come dimostro che le mie traduzioni IA sono state revisionate da un umano (articolo 50 dell’EU AI Act)?
Con una registrazione di provenance. Locize registra ogni decisione accetta/rifiuta con revisore, marca temporale, fonte della traduzione (umano, macchina o IA) e punteggio di confidenza IA al momento della decisione, e l’export di provenance impacchetta tutto in un report CSV + JSON per versione, lingua o namespace. L’articolo 50 dell’EU AI Act è in vigore dal 2 agosto 2026; il testo passato per una revisione umana con responsabilità editoriale è sulla via dell’esenzione, e questo export è l’evidenza che consegnate a un auditor.
Stanchi di gestire le traduzioni a mano?
Locize è il backend di gestione delle traduzioni creato dal team di i18next: distribuzione via CDN, traduzione con AI, editing in-context, senza nuovi deploy.
Iniziate la prova gratuita di 14 giorniArticoli correlati