Sur cette page
- Ce que contient une entrée de glossaire
- Glossaire, guide de style, mémoire de traduction : trois choses différentes
- Pourquoi la traduction automatique et l'IA ont plus besoin d'un glossaire que les traducteurs
- Comment un glossaire est appliqué
- Comment les équipes construisent et entretiennent leurs glossaires aujourd'hui
- Ce qu'un glossaire ne résout pas
- Comment cela fonctionne dans Locize
- Questions fréquentes
Un glossaire de traduction (aussi appelé base terminologique ou termbase) est une liste soignée des termes qu'un produit doit traduire de la même façon à chaque fois, avec la traduction approuvée pour chaque langue et, quand cela compte, les variantes autorisées et celles qui sont interdites. Il couvre les mots qui portent du sens pour vos utilisateurs : noms de produits et de fonctionnalités, actions de l'interface, termes juridiques et métier, et mots qui doivent rester non traduits. Il ne couvre ni les phrases, ni le ton, ni la grammaire ; ceux-là relèvent de la mémoire de traduction et du guide de style.
Ce billet est le billet de définition : ce que contient une entrée, en quoi un glossaire diffère des deux choses avec lesquelles on le confond le plus souvent, pourquoi la traduction automatique et l'IA en dépendent plus que les traducteurs, comment il est appliqué, et ce qu'il ne corrige pas.
- Une entrée, un concept : le terme source, la traduction préférée par langue, les variantes autorisées, les termes interdits, et éventuellement une définition ou une note d'usage. « Ne pas traduire » est une entrée valide ; c'est là que vivent les noms de produits.
- Glossaire, guide de style et mémoire de traduction sont trois choses différentes : des termes, des règles de voix, et des phrases déjà traduites. Les trois alimentent le même traducteur, le même modèle et le même agent.
- La traduction automatique et l'IA en ont plus besoin que les humains : chaque requête de modèle démarre sans mémoire, si bien que le glossaire est le seul mécanisme qui transporte une décision terminologique jusqu'à la requête suivante.
- La mise en application est un contrôle, pas un document : à chaque traduction enregistrée, un terme interdit ou un terme approuvé manquant déclenche un constat ; les contrôles de cohérence à l'échelle du corpus montrent quels termes devraient être dans le glossaire et n'y sont pas encore.
Ce que contient une entrée de glossaire
Un glossaire est une liste de concepts, pas une liste de mots, et cette distinction décide de son utilité. L'entrée d'un concept comme « subscription » contient :
- Le terme source tel qu'il apparaît dans votre produit, idéalement avec une courte définition ou une note d'usage pour que « subscription » l'objet de facturation ne soit pas confondu avec « subscribe » l'action d'inscription à la newsletter.
- La traduction préférée par langue. Un terme, celui que le produit utilise partout : « Abo » en allemand, pas « Abonnement », pas « Subskription ».
- Les variantes autorisées, quand une variante est acceptable dans certains contextes : une forme longue pour un texte juridique, une abréviation pour un bouton étroit.
- Les termes interdits : les traductions employées à un moment donné et qui ne doivent pas revenir, le terme d'un concurrent, ou un mot qui a un autre sens dans votre domaine. Les termes interdits sont ce qui rend un glossaire applicable, parce que « utilisez X » est difficile à vérifier et « n'utilisez jamais Y » est facile.
- Les entrées à ne pas traduire. Noms de produits, noms de marques, marques déposées et certains identifiants techniques sont des entrées de glossaire dont la traduction dans chaque langue est égale à la source. Sans l'entrée, chaque traducteur et chaque modèle décide pour lui-même.
Un glossaire de quarante concepts bien choisis vaut plus qu'un glossaire de quatre cents mots génériques. Les concepts qui y ont leur place sont ceux dont un rendu faux ou incohérent coûte quelque chose : de l'argent, de la confiance, une exposition juridique, ou un ticket de support.
Glossaire, guide de style, mémoire de traduction : trois choses différentes
On les confond constamment, en partie parce qu'un bon outil de traduction affiche les trois à côté du segment en cours de traduction.
| Glossaire | Guide de style | Mémoire de traduction | |
|---|---|---|---|
| Unité | Un terme (mot ou courte expression) | Une règle (ton, formalité, public, à faire et à ne pas faire) | Un segment (une phrase déjà traduite) |
| Écrit par | Les personnes qui décident comment le produit parle | Les personnes qui décident comment la marque sonne | Personne ; collectée automatiquement à partir des traductions passées |
| Répond à | Quel mot utilisons-nous pour ce concept ? | Comment nous adressons-nous à l'utilisateur, dans quel registre ? | Avons-nous déjà traduit cette phrase ? |
| Change quand | Un terme produit ou métier est introduit ou renommé | La voix de la marque change | À chaque traduction enregistrée |
| Appliqué par | Des contrôles de termes à chaque enregistrement | L'injection dans les prompts MT et IA, la relecture humaine | Des suggestions de correspondance avec un score de similarité |
Le guide de style dit au traducteur, au modèle ou à l'agent que l'allemand utilise le « Sie » de politesse et que le public est composé de développeurs ; le glossaire leur dit que « subscription » se dit « Abo » ; la mémoire de traduction leur dit que « Your subscription ends tomorrow » a été traduit l'an dernier, et comment. Retirez l'un des trois et une classe précise de défauts revient.
Pourquoi la traduction automatique et l'IA ont plus besoin d'un glossaire que les traducteurs
Un traducteur humain qui a travaillé sur votre produit le mois dernier se souvient de votre nom de produit, de votre mot allemand pour subscription et du fait que « Open » est un bouton. Un moteur de traduction automatique ou un modèle de langage non, parce que chaque requête démarre sans mémoire. Envoyez le même terme source dans douze lots sur une année et vous obtenez plusieurs rendus, chacun défendable isolément. Les utilisateurs voient les écrans côte à côte ; le modèle jamais.
Cela fait du glossaire la pièce porteuse de toute configuration de traduction automatisée, dans deux rôles distincts :
- Comme entrée. Les termes pertinents sont appliqués à la requête : injectés dans le prompt IA sous la forme « utilise exactement ces traductions », ou appliqués comme table de correspondance par un moteur de traduction automatique qui prend en charge la terminologie. C'est ainsi que la décision de l'an dernier atteint le lot de ce matin.
- Comme contrôle a posteriori. Les modèles paraphrasent, les moteurs ignorent les indications, et un terme interdit revient quand même. Un contrôle qui signale un terme interdit dans une traduction enregistrée attrape ce que l'entrée n'a pas empêché.
La même logique s'applique aux agents de code IA qui rédigent des traductions dans un changement de code : le glossaire doit être quelque chose que l'agent interroge avant de rédiger, pas un document qu'il a peut-être lu.
Comment un glossaire est appliqué
Un glossaire qui vit dans un PDF est un souhait. L'application signifie que le glossaire s'exécute comme un contrôle là où les traductions sont enregistrées, avec des constats attachés au segment :
- Terme interdit trouvé. La traduction contient un terme que le glossaire interdit pour cette langue. C'est le constat à haute précision : il n'y a aucune raison légitime que le mot soit là.
- Terme approuvé manquant. Le texte source correspond à une entrée du glossaire, mais la traduction n'utilise aucun des termes approuvés pour cette langue. Précision plus faible, parce que la flexion et l'ordre des mots peuvent masquer un terme correct, mais c'est le constat qui attrape un modèle inventant discrètement son propre rendu.
- Traduction incohérente de la même valeur source, à l'échelle du corpus. Pas strictement un contrôle de glossaire, et c'est bien le point : il trouve les termes traduits de trois façons différentes qui ne sont pas encore dans le glossaire. Le résultat de ce contrôle est l'entrée de la prochaine revue du glossaire.
Des constats que les relecteurs peuvent écarter segment par segment, quand un écart est volontaire, sont ce qui maintient les contrôles activés. Un contrôle sans échappatoire ciblée est désactivé en quelques semaines. La taxonomie plus large de ce que les contrôles automatiques attrapent, et la part mesurée de segments concernés, sont dans ce qui casse vraiment dans les traductions.
Comment les équipes construisent et entretiennent leurs glossaires aujourd'hui
- Un tableur. Une ligne par concept, une colonne par langue, partagé avec l'agence. Le point de départ le plus courant, et très bien comme source ; le problème est qu'il n'est relié à rien, si bien que l'application dépend de qui pense à l'ouvrir.
- L'extraction de termes à partir des traductions existantes. Fouiller le corpus à la recherche de termes récurrents et, plus utile encore, de termes déjà traduits de façon incohérente : ce sont les entrées dont le glossaire a besoin en premier. Les outils peuvent suggérer des candidats ; une personne les approuve, parce qu'une entrée de glossaire est une décision, pas une statistique.
- Un fichier d'échange terminologique. TBX (le standard XML ISO 30042) et UTX (un format tabulé de l'AAMT) font circuler les glossaires entre outils de traduction et agences ; la référence des formats TBX et UTX couvre les deux.
- Un glossaire dans le système de gestion de traduction. Les termes sont montrés au traducteur à côté du segment, injectés dans la traduction automatique et l'IA, et contrôlés à chaque enregistrement. C'est la configuration où le glossaire cesse d'être un document.
La règle d'entretien est la même partout : revoir le glossaire chaque fois qu'un terme produit est introduit ou renommé, et chaque fois que le contrôle de cohérence fait remonter un nouveau désaccord. Un glossaire que personne ne met à jour décrit fidèlement le produit d'il y a deux ans.
Ce qu'un glossaire ne résout pas
- Les phrases. Un glossaire garantit le terme, pas la phrase autour. La fluidité, le sens et le registre sont le travail du traducteur, du modèle avec un guide de style, et de la relecture.
- L'ambiguïté que l'entrée n'a pas anticipée. « Open » le verbe et « Open » le statut sont deux concepts ; si le glossaire n'a qu'une entrée, il impose la mauvaise quelque part. Les entrées ont besoin de définitions, et les cas ambigus ont besoin de contexte ou de captures d'écran.
- La flexion et la grammaire. Le terme allemand préféré se décline ; un contrôle doit tolérer « Abos » comme « Abonnements », et une correspondance exacte naïve produit du bruit au lieu de constats.
- La qualité de la décision elle-même. Un glossaire impose la cohérence, pas la justesse. Si le terme approuvé est faux, il est maintenant faux partout, de façon cohérente. C'est tout de même mieux qu'être faux de trois façons différentes, parce qu'une seule entrée le corrige.
Comment cela fonctionne dans Locize
Le glossaire dans Locize est une liste de concepts au niveau du projet avec les termes préférés, autorisés et interdits par langue.
- Le construire. Importez un fichier TBX ou UTX, ajoutez des termes à la main, ou laissez Locize fouiller vos traductions existantes : Scan for terms liste les termes récurrents à travers vos clés, ceux actuellement traduits de façon incohérente en premier. Rien n'est ajouté automatiquement ; vous approuvez chaque candidat, prérempli avec les traductions déjà utilisées dans le projet.
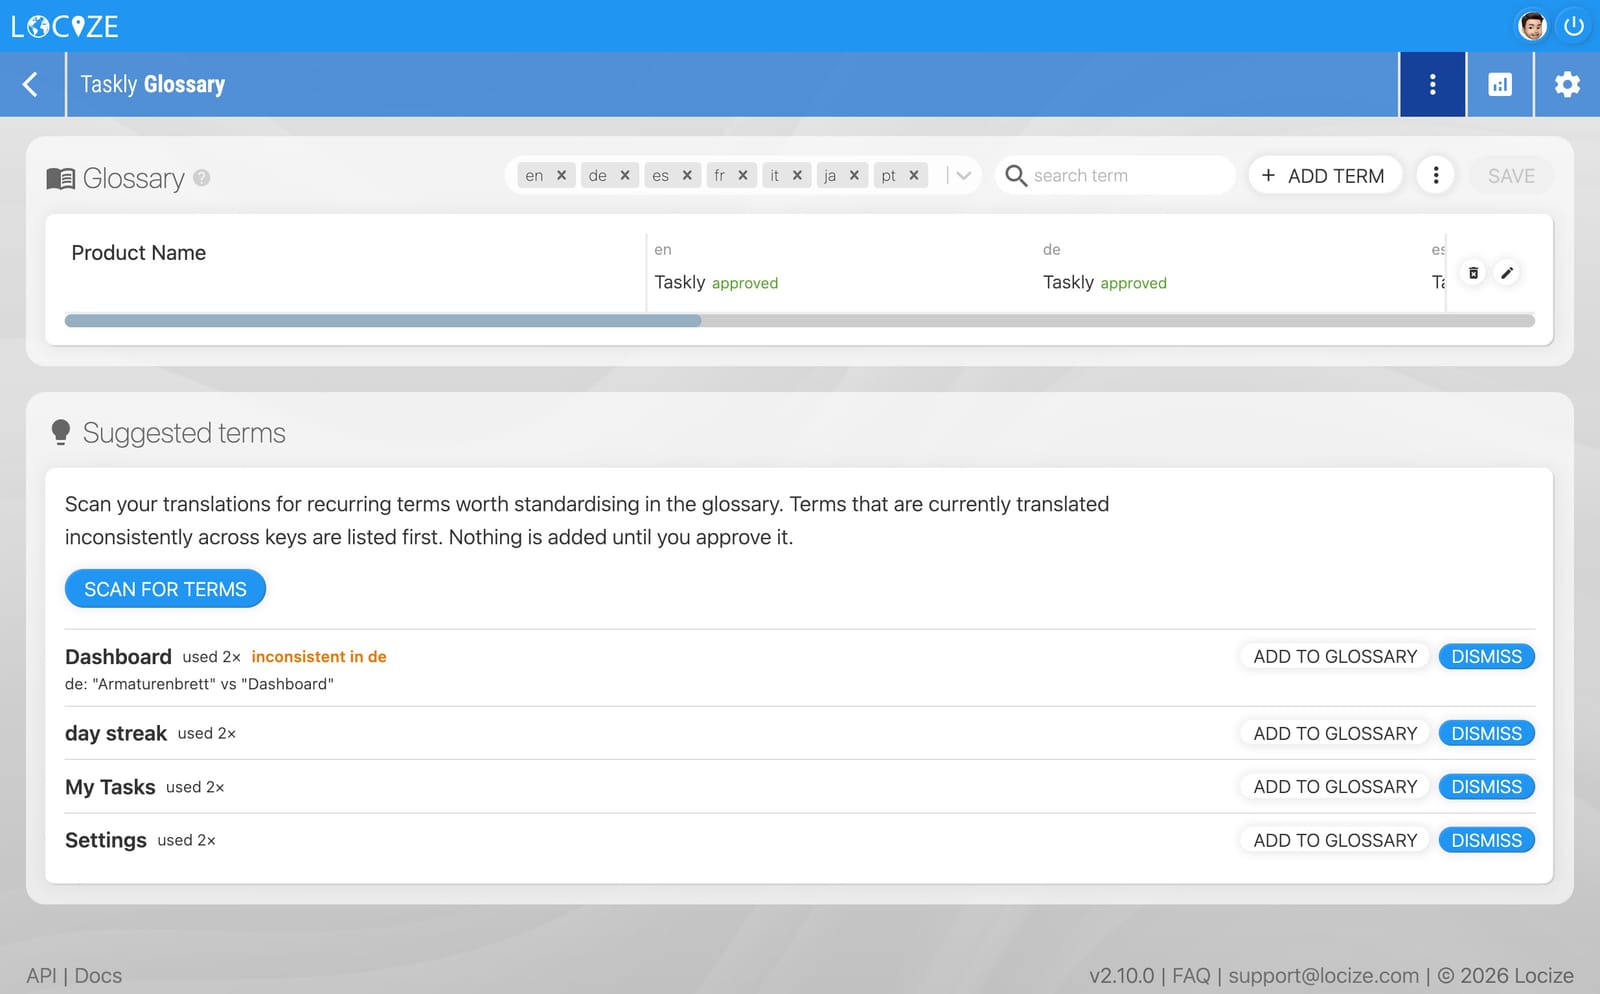
- L'utiliser. Dans l'éditeur, chaque segment montre les termes du glossaire correspondants à côté de la traduction, avec l'usage approuvé et les alternatives. Les mêmes termes sont injectés dans la traduction automatique, dans la traduction automatique et IA en masse et dans l'assistant IA, avec le guide de style, et exposés aux agents de code IA via l'outil
get_glossarydu serveur MCP, décrit dans le billet sur les outils de contexte.
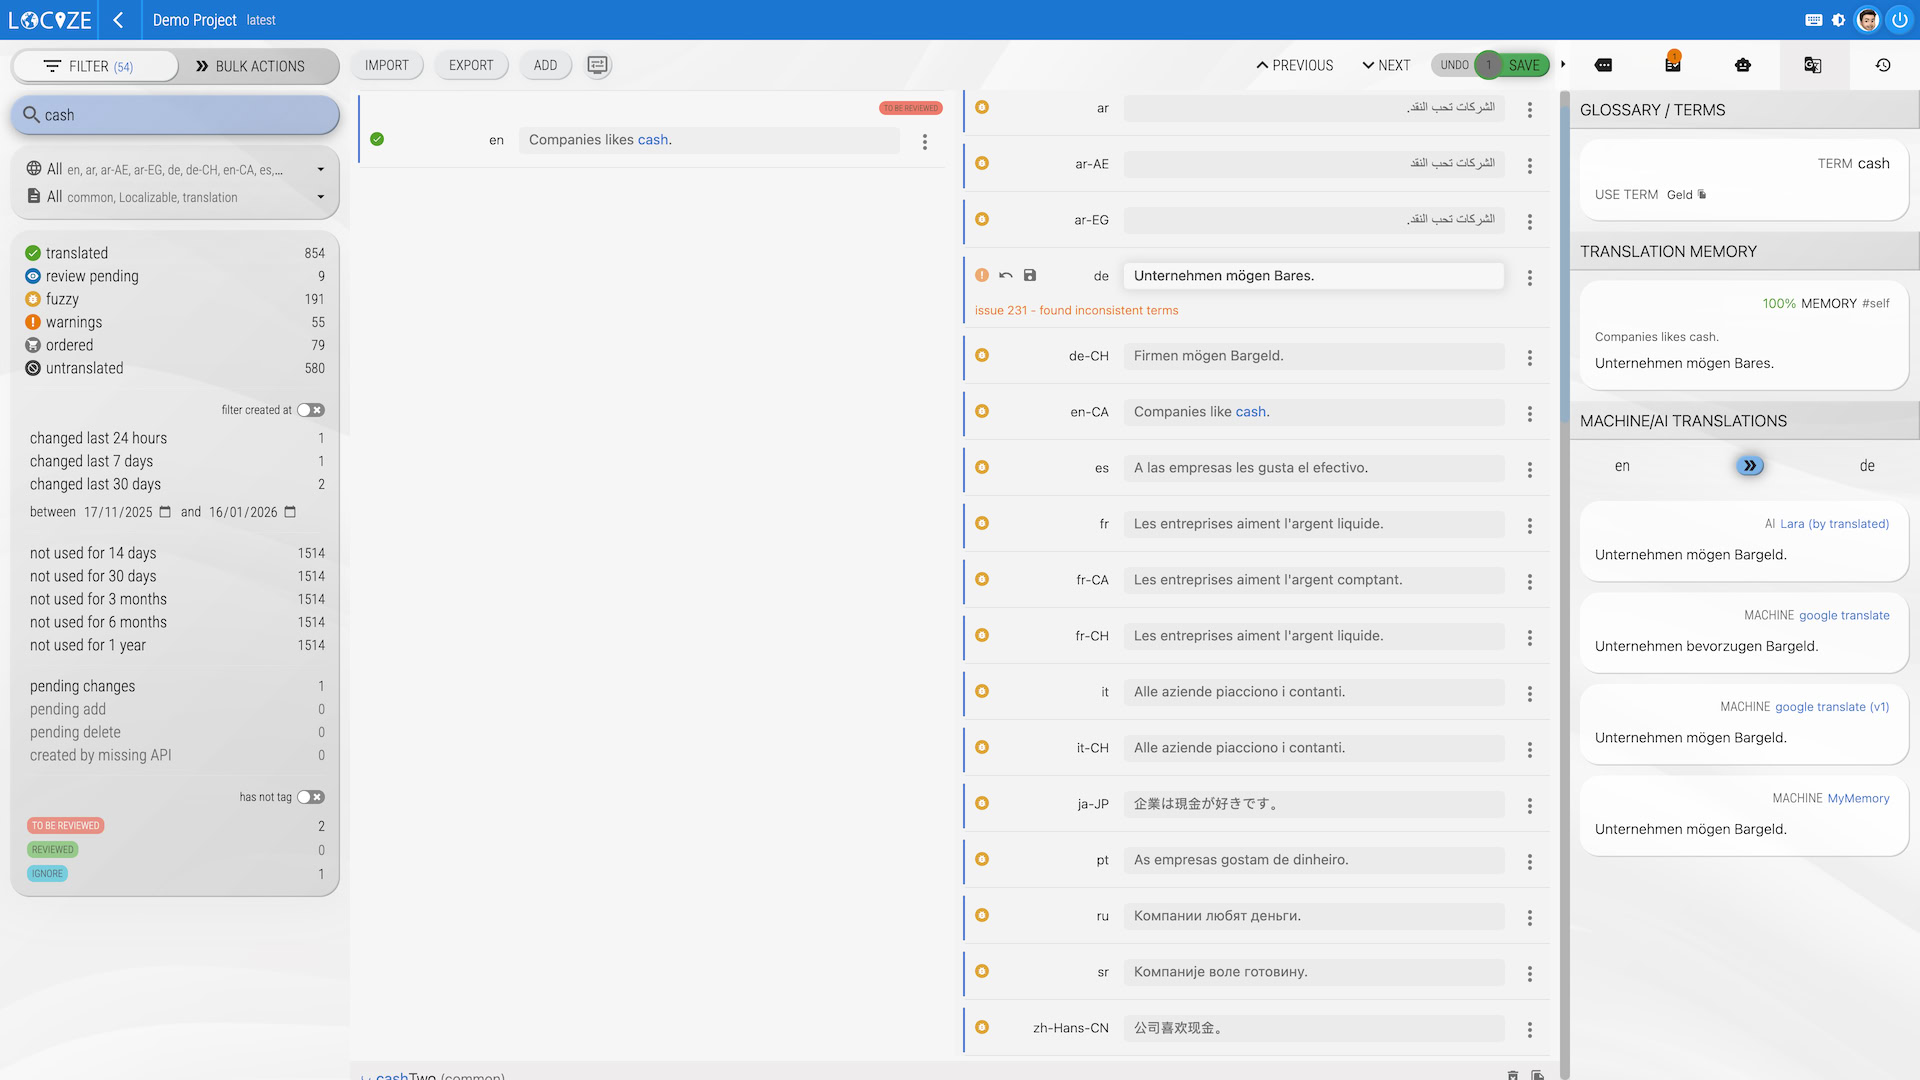
- L'appliquer. Les termes sont contrôlés à chaque mise à jour d'une traduction : un terme interdit déclenche le problème 230, un terme source reconnu sans terme cible approuvé déclenche le problème 231, tous deux documentés sous contrôles de cohérence du glossaire. Le contrôle de cohérence à l'échelle du corpus pour une même valeur source traduite différemment s'exécute à la demande, pour un segment ou tout le projet, et ses constats sont la présélection du prochain scan.
Si vous voulez savoir quels termes votre projet traduit déjà de façon incohérente : créez un projet, importez vos fichiers de traduction, ouvrez le glossaire et cliquez sur Scan for terms. La première liste est généralement plus longue que prévu, et plus courte qu'elle ne le sera l'an prochain.
Questions fréquentes
Qu'est-ce qu'un glossaire de traduction ?
Un glossaire de traduction (aussi appelé base terminologique ou termbase) est une liste soignée des termes qu'un produit doit traduire de la même façon à chaque fois, avec la traduction approuvée pour chaque langue et, quand cela compte, les variantes autorisées et celles qui sont interdites. Il couvre les noms de produits et de fonctionnalités, les actions de l'interface, les termes juridiques et métier, et les mots qui doivent rester non traduits. Il ne couvre ni les phrases entières, ni le ton, ni la grammaire.
Quelle est la différence entre un glossaire de traduction et une mémoire de traduction ?
Un glossaire stocke des termes : des mots isolés ou de courtes expressions avec leur traduction approuvée par langue, tenus à jour par des personnes qui décident comment le produit parle. Une mémoire de traduction stocke des segments : des phrases déjà traduites, collectées automatiquement au fil de la traduction et proposées à nouveau quand une phrase similaire se présente. Le glossaire répond à « quel mot utilisons-nous pour ce concept » ; la mémoire répond à « avons-nous déjà traduit cette phrase ». La plupart des équipes ont besoin des deux.
Quelle est la différence entre un glossaire et un guide de style ?
Un glossaire est une liste de termes avec leurs traductions. Un guide de style est un ensemble de règles sur la voix : ton, niveau de formalité, public cible, exemples à faire et à ne pas faire, généralement par langue. Le glossaire dit que le mot allemand pour subscription est Abo ; le guide de style dit que l'allemand s'adresse à l'utilisateur avec le Sie de politesse. Les deux sont des entrées pour les traducteurs, la traduction automatique et l'IA, et aucun ne remplace l'autre.
Ai-je besoin d'un glossaire pour la traduction automatique ou l'IA ?
Plus que pour des traducteurs humains. Un traducteur se souvient des décisions du mois dernier ; un appel de modèle non, car chaque requête démarre sans mémoire. Un glossaire est le mécanisme qui transporte les décisions terminologiques jusqu'à la requête suivante : ses termes sont injectés dans le prompt de traduction ou appliqués comme table de correspondance, et un contrôle des termes interdits attrape la dérive qui passe malgré tout. Sans lui, le même concept est rendu différemment d'un lot à l'autre et personne ne le remarque jusqu'à ce que les utilisateurs voient les écrans côte à côte.
Comment un glossaire est-il appliqué automatiquement ?
Comme un contrôle qui s'exécute à chaque traduction enregistrée, pas comme un document que les traducteurs doivent mémoriser. Deux constats couvrent le sujet : la traduction contient un terme que le glossaire interdit, ou le texte source correspond à une entrée du glossaire mais la traduction n'utilise aucun des termes approuvés pour cette langue. Un contrôle de cohérence à l'échelle du corpus complète le tout en faisant remonter les termes traduits de façon incohérente qui ne sont pas encore dans le glossaire, ce qui est exactement la liste de ce qu'il faut ajouter ensuite.
Quel est le format de fichier d'un glossaire de traduction ?
Les formats d'échange sont TBX (TermBase eXchange, le standard XML ISO 30042 utilisé par les systèmes terminologiques professionnels) et UTX (un format tabulé de l'AAMT). En pratique, beaucoup de glossaires commencent comme un tableur avec une ligne par concept et une colonne par langue. Un système de gestion de traduction importe du TBX ou de l'UTX, ou permet d'ajouter des termes directement, et garde le glossaire à côté des traductions qu'il régit.
Fatigué de gérer vos traductions à la main ?
Locize est le backend de gestion de traductions créé par l'équipe i18next : diffusion CDN, traduction IA, édition in-context, sans redéploiement.
Démarrez votre essai gratuit de 14 joursArticles similaires