Auf dieser Seite
Continuous Deployment verspricht vor allem eines: Jede Änderung, vom einzeiligen Bugfix bis zum neuen Feature, kann sicher und in eigenem Takt vom Commit in die Produktion wandern. Die meisten Teams haben Jahre gebraucht, um dorthin zu kommen. Dann fügen sie eine zweite Sprache hinzu, und mitten in der Pipeline taucht stillschweigend ein Schritt wieder auf, den niemand automatisiert hat: der Batch-Übersetzungs-Handoff.
Auf den ersten Blick sieht das nicht wie ein Deployment-Problem aus. Es sieht wie ein Prozess aus: Strings exportieren, an einen Übersetzungsdienstleister senden, warten, Dateien zurückbekommen, importieren, Konflikte auflösen, neu deployen. Aber dieser Roundtrip ist ein release-blockierender Schritt im Kostüm eines Workflows, und er bricht Continuous Deployment auf konkrete, vorhersehbare Weise.
Das ist die Engineering-Version des Warum, und wie die kontinuierliche Alternative tatsächlich aussieht, wenn sie in CI/CD verdrahtet ist.
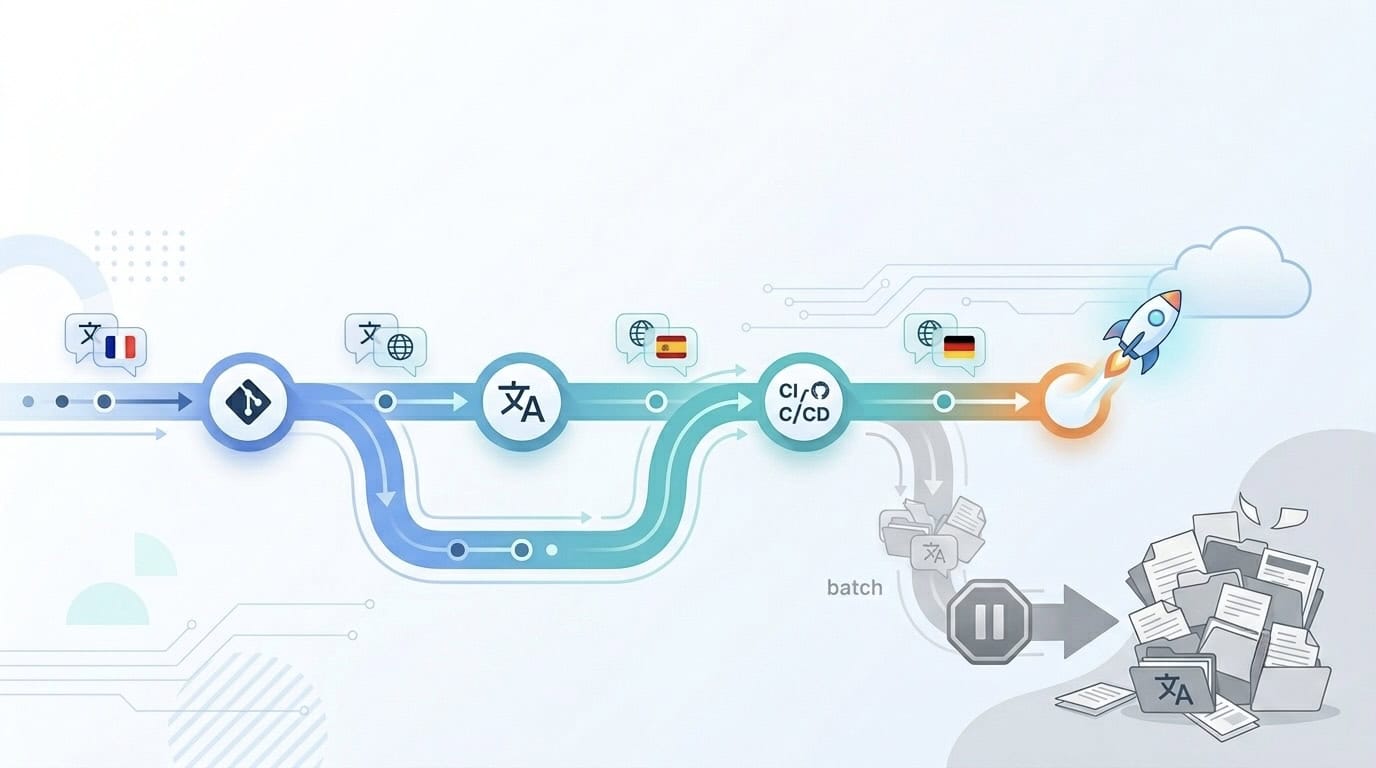
- Batch-Übersetzung: in Dateien exportieren, an einen Dienstleister übergeben, warten, reimportieren, neu deployen. Ein serialisierter, ausserhalb der Pipeline liegender Schritt in einem ansonsten automatisierten Ablauf.
- Der Bruch: Übersetzungen landen, nachdem das Feature ausgeliefert wurde, Reimporte kollidieren mit Code, der sich weiterentwickelt hat, und eine einzelne Korrektur braucht ein vollständiges Redeploy. Teams kompensieren mit einem Content-Freeze.
- Kontinuierliche Lokalisierung: Keys erreichen das TMS aus Ihrem Code, ein CLI hält in CI alles synchron, und Übersetzungen werden ohne Redeploy über ein CDN ausgeliefert.
- Qualität, kontinuierlich: KI-Auto-Übersetzung plus Quality Estimation erledigt den Grossteil; nur Strings mit geringer Konfidenz gehen ins menschliche Review.
Wie ein Batch-Übersetzungs-Workflow CI/CD bricht
Continuous Deployment funktioniert, weil jeder Schritt automatisiert, schnell und umkehrbar ist. Ein Batch-Handoff ist nichts davon. Hier bricht es konkret.
Er serialisiert einen parallelen Prozess. Entwicklung ist kontinuierlich; ein Batch-Handoff ist ein Stopp. Sie stellen ein Feature fertig und warten dann Tage oder Wochen auf Übersetzungen, bevor die lokalisierte Version ausgeliefert werden kann. Das Feature ist fertig, die Übersetzung nicht, und das Release ist Geisel der langsamsten Sprache. Continuous Deployment sollte genau diese Art von Gate beseitigen.
Der Reimport kollidiert mit Code, der sich weiterentwickelt hat. Bis die übersetzten Dateien zurückkommen, hat sich die Codebasis verändert: Keys wurden umbenannt, Strings aufgeteilt, ein Screen refaktoriert. Das Mergen der zurückgelieferten Dateien ist eine manuelle Konfliktauflösung, dasselbe Problem wie bei einem langlebigen Branch, nur dass der Branch ein Ordner voller .json- oder .xliff-Dateien ist, gepflegt von Leuten ausserhalb Ihres Repos. Je länger der Batch, desto schlimmer der Merge.
Eine Ein-Wort-Korrektur wird zum vollständigen Release. Sie haben einen Tippfehler im deutschen Text gefunden oder einen String, der seinen Button sprengt? In einem Batch-and-Bundle-Modell muss die korrigierte Datei committet, gebaut und durch die gesamte Pipeline neu deployt werden. Text, der nichts mit Code zu tun hat, hängt jetzt hinter einem Code-Deploy. Das ist verkehrt herum.
Er drängt Teams in einen Content-Freeze. Weil der Roundtrip langsam und riskant ist, besteht die übliche Verteidigung darin, alle Strings zwei bis drei Monate vor einem Launch einzufrieren, damit Zeit zum Übersetzen bleibt. Jetzt wird die schnelllebige Hälfte des Produkts (der Text) eingefroren, um sich der langsamen Hälfte (dem Batch) anzupassen. Die versteckten Kosten davon, die Koordination, die erneuten Roundtrips, der verzögerte Rollout, übersteigen meist die Kosten der Übersetzung selbst.
Er hat keinen geteilten Zustand. Dateien auf dem Weg zu einem Dienstleister haben keinen Nachweis, wer was geprüft hat, welche Strings freigegeben sind, was die vereinbarte Terminologie ist oder wie konfident eine bestimmte Übersetzung ist. Dieser Zustand lebt in E-Mail-Threads und Tabellen, nicht in Ihrer Pipeline. CI kann nicht darüber schliessen, also kann CI nicht darauf gaten.
Nichts davon ist die Schuld der Übersetzer, und es wird nicht durch schnelleres Übersetzen gelöst. Es ist ein Architekturproblem: Ein serialisierter, zustandsbehafteter, manueller Schritt wurde in eine Pipeline eingefügt, die parallel, zwischen Läufen zustandslos und automatisiert sein soll.
Wie kontinuierlich aussieht, in die Pipeline verdrahtet
Die Lösung besteht darin, Übersetzungen so zu behandeln, wie Sie Code und Config bereits behandeln: Sie fliessen kontinuierlich durch die Pipeline, haben ihren eigenen Auslieferungskanal und blockieren nie ein Release. Konkret gibt es mit i18next und Locize drei bewegliche Teile.
1. Keys erreichen das TMS aus Ihrem Code, nicht aus einer Tabelle
Wenn Sie ein neues Feature schreiben, sollten die neuen Übersetzungs-Keys in dem Moment im Übersetzungssystem auftauchen, in dem sie im Code existieren. i18nexts saveMissing tut genau das: Jeder Key, der noch keinen Wert hat, wird automatisch gemeldet.
import i18next from 'i18next'
import LocizeBackend from 'i18next-locize-backend'

i18next.use(LocizeBackend).init({
  // ...
  saveMissing: true, // neue Keys erscheinen in Locize, während Sie coden
  backend: {
    projectId: '<your-project-id>',
    apiKey: '<your-api-key>', // nur in der Entwicklung, niemals in die Produktion ausliefern
    referenceLng: 'en'
  }
})
Das läuft in der Entwicklung und nur aus der Referenzsprache, sodass die Single Source of Truth für "was übersetzt werden muss" Ihr tatsächlicher Code ist, kein manuell gepflegter Export. Es gibt keinen Batch zusammenzustellen, weil die Liste immer aktuell ist.
2. Ein CLI-Schritt hält in CI alles synchron
In Ihrer Pipeline gleicht das locize CLI Ihre lokalen Referenz-Strings mit dem Projekt ab und holt Übersetzungen zurück. Es macht ein echtes Diff (hinzufügen, aktualisieren, entfernen) statt eines blinden Überschreibens, und Sie können es für automatisierte Läufe konservativ einstellen:
# In CI: Referenz-Keys pushen, Übersetzungen pullen, nichts automatisch löschen
locize sync \
  --project-id <your-project-id> \
  --api-key $LOCIZE_API_KEY \
  --ver latest \
  --path ./locales \
  --update-values false \
  --skip-delete true
Standardmässig betrachtet sync nur die Referenzsprache (--reference-language-only true) und sichert alle Segmente, die es entfernen würde, bevor es sie anrührt. Führen Sie es zuerst mit --dry true aus, um das Diff ohne Schreiben zu sehen. Der Punkt ist, dass Übersetzungs-Drift zu einem sichtbaren, skriptbaren Schritt in CI wird statt zu einem manuellen Merge im Nachhinein.
3. Publishen Sie beim Deploy eine gepinnte Version
Das ist der Teil, der ein Release tatsächlich atomar macht. Ihre App lädt Übersetzungen aus einer benannten Version (denken Sie an latest für die Arbeitskopie, production für das Ausgelieferte), und Sie publishen diese Version genau in dem Moment, in dem Sie deployen:
# Letzter Pipeline-Schritt, parallel zu Ihrem Code-Deploy
locize publish-version --ver production --project-id <your-project-id> --api-key $LOCIZE_API_KEY
Weil die laufende App auf eine Version gepinnt ist statt die Live-Arbeitskopie zu lesen, sickern laufende Edits nie mitten im Deploy in die Produktion. Und weil Übersetzungen über ein CDN ausgeliefert werden, erreicht eine zwischen Releases gepublishte Textkorrektur die Nutzer ohne Redeploy. Das i18next-Backend holt in seinem eigenen Intervall neu; Sie liefern die Korrektur des deutschen Tippfehlers ohne Release aus, sobald der CDN-Cache abläuft.
Das Release bleibt atomar und umkehrbar. Textänderungen zwischen Releases fahren auf einem separaten, schnelleren Kanal. Keines blockiert das andere.
Für die Definition und die vier Stufen siehe Was ist Continuous Localization?; wie Locize sie umsetzt, zeigt die Seite zur Continuous-Localization-Plattform; und wie sich das Modell entwickelt hat, die ursprüngliche Sicht auf Continuous Development, Integration und Lokalisierung.
Qualität ohne ein Batch-Review-Gate
Der ehrliche Einwand gegen "Übersetzungen kontinuierlich ausliefern" ist Qualität. Der ganze Grund, warum Batches existieren, ist der menschliche Review-Schritt. Aber Sie brauchen keinen Batch, um Review zu bekommen; Sie brauchen ein Review, das kontinuierlich und selektiv ist statt auf einen Schlag.
Wenn ein neuer Key eintrifft, übersetzt Locize ihn automatisch. Sie können Ihren eigenen Provider-Key mitbringen (OpenAI, Gemini, Mistral, DeepL oder Lara) oder die eingebaute KI nutzen, und das Ergebnis wird dann von Quality Estimation auf einer Skala von 0 bis 1 bewertet. Das Routing ist der wichtige Teil:
- Übersetzungen über dem Schwellenwert (standardmässig 0,7) werden gespeichert und können automatisch publisht werden.
- Übersetzungen unter dem Schwellenwert oder mit einem schwerwiegenden Problem markierte werden in den menschlichen Review-Workflow geroutet.
Statt dass also eine Person einmal im Quartal Tausende Strings in einer exportierten Datei prüft, sehen Ihre Reviewer nur die Strings, die wirklich einen Menschen brauchen, im Kontext, sobald sie auftauchen. Ein Glossar und ein Styleguide halten Terminologie und Brand Voice über das Ganze hinweg konsistent. Das Review-Gate existiert weiterhin; es ist nur kein Batch mehr.
Rollen (Admin, Manager, Publisher, Translator), Scopes pro Sprache und pro Namespace sowie ein In-Context-Editor bedeuten, dass Übersetzer und Reviewer direkt gegen das Live-Projekt arbeiten. Es gibt keinen Export zum Verschicken und keine Datei zum Zurückmergen.
Wie Sie von Batch wegkommen
Sie müssen nicht alles auf einmal umbauen. Eine pragmatische Migration:
- Pinnen Sie Ihre App auf eine Version. Zeigen Sie die Produktion auf eine benannte Version (zum Beispiel
production) statt auf die Live-Arbeitskopie. Allein das macht Deploys atomar. - Verschieben Sie den Freeze auf ein Publish. Ersetzen Sie den Content-Freeze durch das Publishen dieser Version beim Deploy. Strings bleiben bis zum Moment des Ausliefern editierbar.
- Bringen Sie
syncin CI. Fügen Sie den CLI-Sync-Schritt hinzu, sodass Drift in der Referenzsprache automatisch erkannt wird, zunächst mit--skip-delete true, bis Sie ihm vertrauen. - Schalten Sie Auto-Übersetzung plus QE ein. Lassen Sie die KI das Volumen abdecken und nur Strings mit geringer Konfidenz an Menschen routen, sodass die Review-Queue klein und kontinuierlich ist.
- Branchen Sie die riskanten Änderungen. Nutzen Sie für ein grosses Rename oder Umbau ein Branch-Projekt, sodass das Experiment die Produktionsversion erst berührt, wenn es gemergt ist.
Jeder Schritt entfernt ein Stück des Batch-Handoffs. Am Ende ist Übersetzung einfach noch etwas, das Ihre Pipeline kontinuierlich erledigt, und "auf Übersetzungen warten" ist kein Posten mehr in Ihrem Release-Plan.
Wo Locize hineinpasst
Continuous Deployment hat das Batch-Modell für Code vor einem Jahrzehnt gebrochen. Dieselbe Logik gilt für die Strings: Ein serialisierter, manueller, zustandsbehafteter Handoff hat in einer automatisierten Pipeline nichts verloren. Locize ist um diese Idee herum gebaut, Keys aus Ihrem Code, ein CLI für CI, versionsgepinntes Publishing, CDN-Auslieferung und KI-Übersetzung, gegated durch Quality Estimation, sodass Lokalisierung nicht mehr der Schritt ist, der das Release blockiert.
Wenn Ihr Übersetzungsprozess noch eine "Dateien rausschicken und warten"-Phase hat, dann ist das der Teil Ihrer Pipeline, den Continuous Deployment nie erreicht hat. Sehen Sie, wie kontinuierliche Lokalisierung funktioniert, oder erstellen Sie ein kostenloses Locize-Konto und verdrahten Sie es in Ihr nächstes Deploy.
Häufig gestellte Fragen
Was ist Continuous Localization Deployment?
Continuous Localization Deployment bedeutet, dass Übersetzungen genauso in Ihr Produkt fliessen wie Code: Keys werden aus der Codebasis erzeugt, während Sie Features schreiben, kontinuierlich übersetzt (per KI, durch Ihr Team oder beides) und an die laufende App ausgeliefert, ohne ein Code-Redeploy. Es gibt keinen Batch-Handoff, bei dem die Entwicklung pausiert, Quelldateien an eine Agentur exportiert und übersetzte Dateien Wochen später wieder importiert werden. Die Übersetzungs-Pipeline läuft parallel zur Entwicklung und liefert in eigenem Takt über ein CDN aus.
Warum bricht Batch-Übersetzung eine CI/CD-Pipeline?
Ein Batch-Workflow fügt einen manuellen, mehrwöchigen, ausserhalb der Pipeline liegenden Schritt (exportieren, senden, warten, importieren, Konflikte auflösen) in eine Pipeline ein, die automatisiert und schnell sein soll. Übersetzungen treffen ein, nachdem das Feature längst ausgeliefert wurde, der Reimport kollidiert mit Code, der sich weiterentwickelt hat, und eine einzelne korrigierte Textzeile erzwingt ein vollständiges Redeploy. Das Ergebnis ist entweder ein Lokalisierungs-Rückstau oder ein Content-Freeze, bei dem Strings zwei bis drei Monate vor dem Launch eingefroren werden. Beides hebelt den Sinn von Continuous Deployment aus.
Wie verdrahtet man Lokalisierung ohne Batch-Handoff in CI/CD?
Drei bewegliche Teile. Erstens: Neue Keys erreichen das Translation-Management-System automatisch aus Ihrem Code (i18next saveMissing in der Entwicklung) statt aus einer Tabelle. Zweitens: Ein CLI-Schritt in CI hält Referenzsprache und Übersetzungen synchron und kann den Build bei Drift fehlschlagen lassen (locize sync). Drittens: Sie publishen beim Deploy eine gepinnte Version (locize publish-version), sodass ein Release atomar ist, während Textkorrekturen zwischen Releases ohne Redeploy über das CDN ausgeliefert werden. KI-Auto-Übersetzung plus Quality Estimation füllt die Lücke kontinuierlich und routet nur Strings mit geringer Konfidenz an das menschliche Review.
Wie behalte ich Übersetzungsqualität ohne ein Batch-Review-Gate?
Sie ersetzen das Agentur-Batch-Gate durch ein kontinuierliches, automatisiertes. Locize übersetzt neue Keys automatisch (mit Ihrem eigenen OpenAI-, Gemini-, Mistral-, DeepL- oder Lara-Key oder der eingebauten KI) und bewertet dann jedes Ergebnis mit Quality Estimation auf einer Skala von 0 bis 1. Übersetzungen über dem Schwellenwert (standardmässig 0,7) werden direkt gespeichert; alles darunter oder mit einem schwerwiegenden Problem markierte wird in den menschlichen Review-Workflow geroutet. Reviewer arbeiten im Kontext innerhalb der App statt in exportierten Dateien, sodass Qualitätskontrolle pro String und kontinuierlich stattfindet, nicht in einem grossen Handoff.
Übersetzungen noch von Hand verwalten?
Locize ist das Translation-Management-Backend vom i18next-Team: CDN-Auslieferung, KI-Übersetzung, In-Context-Editing, keine Redeploys.
14 Tage kostenlos testen